Dez repositorios, varios axentes e ningún susto: así traballamos con Claude Code

BlaBlaNote é un equipo pequeno con dez repositorios: a aplicación, a plataforma de eventos, o motor de matchmaking, a web, a comunidade, a extensión do navegador, a documentación, as probas de extremo a extremo, o cumprimento legal e un máis que non desprega nada. Todo o código escríbeo Claude Code, moitas veces con varias sesións á vez e ás veces con dúas no mesmo repositorio. E despregamos a produción varias veces ao día.
Cun equipo así, o importante é conseguir que nada se rompa mentres se escribe tanto código.
Un axente non se cansa, pero comeza cada sesión sen lembrar o que pasou a semana anterior. Unha persoa si o lembra, durante unhas semanas. Por iso a regra que o ordena todo é sinxela de dicir e bastante máis difícil de cumprir: ningunha regra importante pode depender de que alguén se lembre dela.
Este artigo conta como o facemos. Son tres pezas: un repositorio que garda as regras, uns hooks que as fan cumprir e un bucle que converte cada erro nunha comprobación nova.
O repositorio que non desprega nada
O décimo repositorio chámase planning. Non ten código de produto. Garda o protocolo de traballo que len todas as sesións, os plans de cada fronte aberta, os hooks e os rexistros de incidentes e de achados.
Vive á parte por un motivo práctico. Se o protocolo estivese dentro da aplicación, cada rama tería a súa propia copia e cada copia iría polo seu lado. Separado, sobrevive a calquera rama e a calquera copia de traballo, e todas as sesións arrancan desde el cos repositorios de produto ao lado.
Os plans levan o seu estado ao principio. Cada plan comeza cunha liña Estado: e un índice agrúpaos por fronte e di cal manda en cada unha. Unha soa orde saca o estado de todos, así que antes de dar algo por pendente ou por feito pódese comprobar en segundos. Un plan novo sen a súa liña de estado ou sen a súa entrada no índice xera un aviso automático.
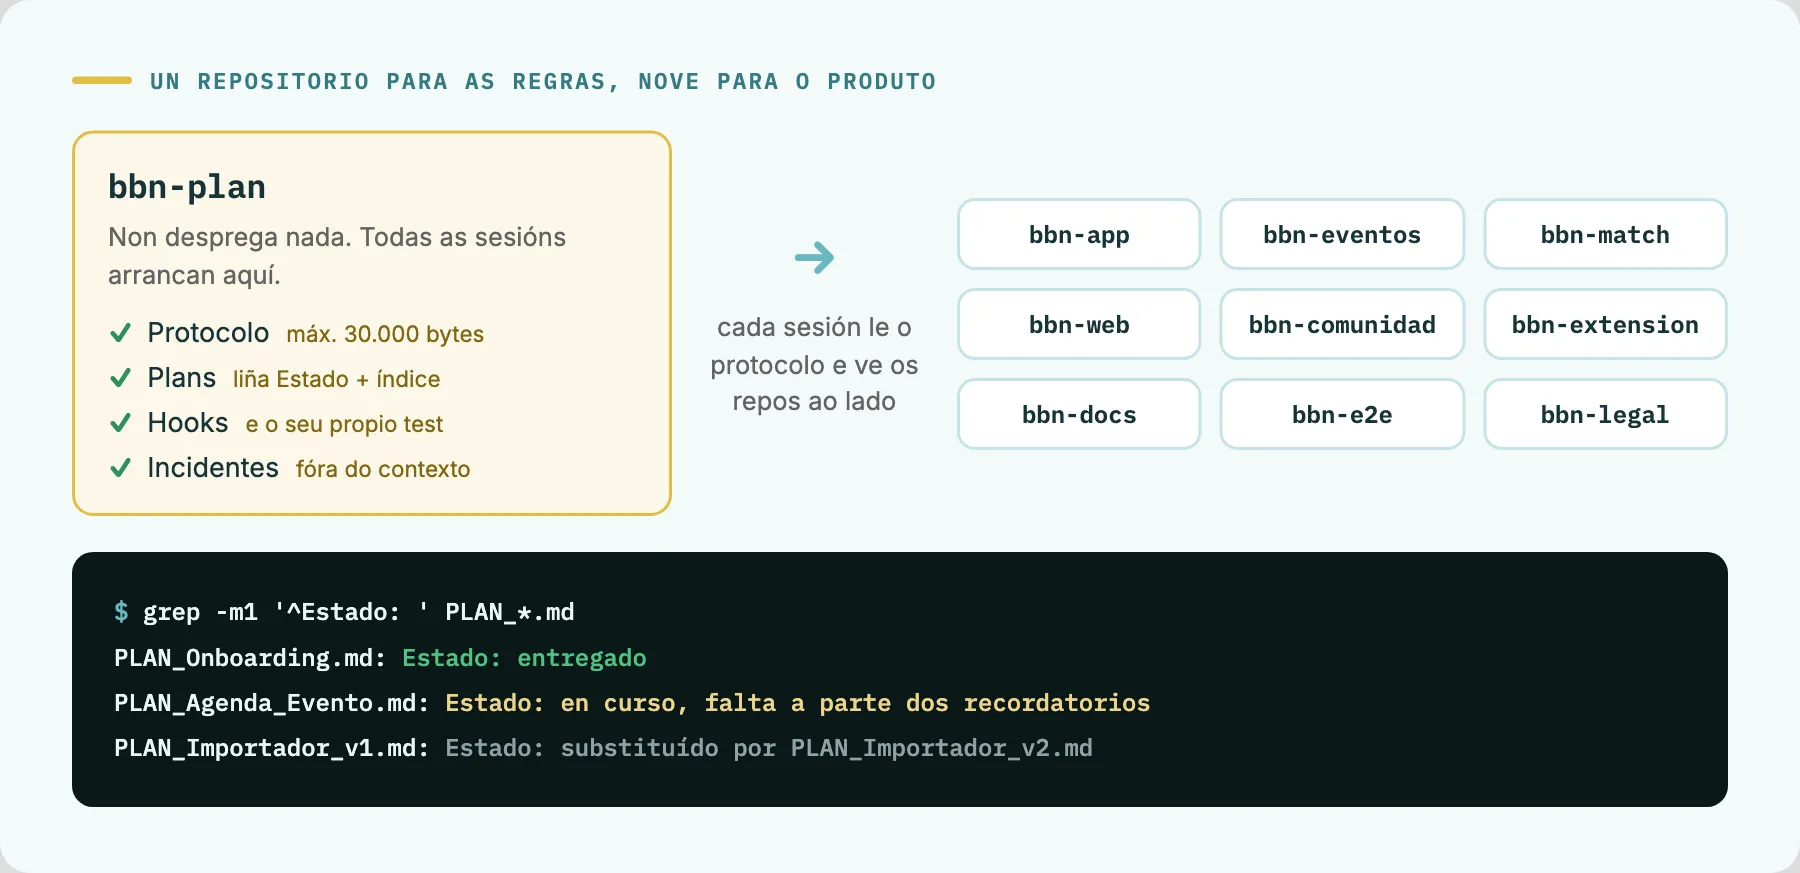
O protocolo ten orzamento. Ten un teito de 30.000 bytes, e pasarse dá un aviso. Isto parece un detalle e é o máis importante de todo o repositorio. Cada sesión de Claude Code carga o protocolo enteiro no seu contexto, e un protocolo que medra sen límite remata como calquera manual longo: ninguén o le de verdade. A regra de poda é esta: todo aviso que xa ten unha máquina detrás redúcese a unha liña que di que pasa e quen o vixía. A historia completa (data, síntoma, causa, medidas) vai a un ficheiro de incidentes que ningunha sesión carga.
Unha tarefa, de principio a fin
Así percorre unha tarefa o camiño ata produción.
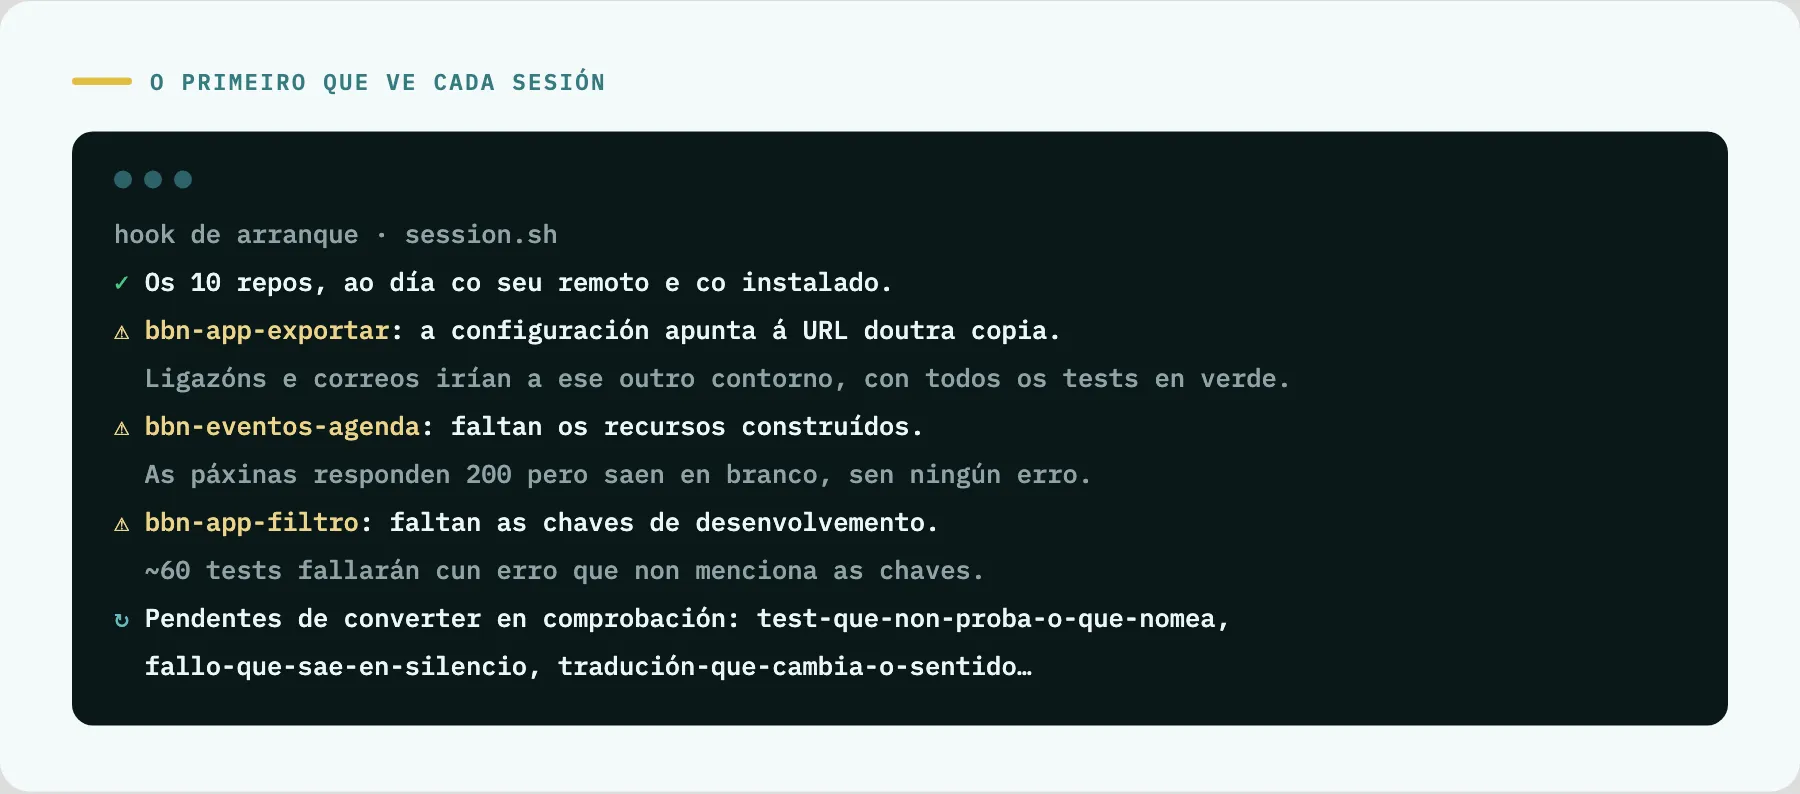
1. Arrancar con todo ao día. Ao comezar a sesión, un hook trae os cambios dos dez repositorios e compara cada un co seu remoto e co que ten instalado. Ler código vello non dá ningún erro: nin ao lelo nin ao mirar o seu historial. Ademais, o hook revisa cada copia de traballo e avisa do que fallaría sen dicir nada, como unha configuración que apunta ao contorno doutra copia ou uns recursos sen construír. Son fallos que acaban en tests verdes que non proban nada, ou en correos que saen cara ao sitio equivocado.
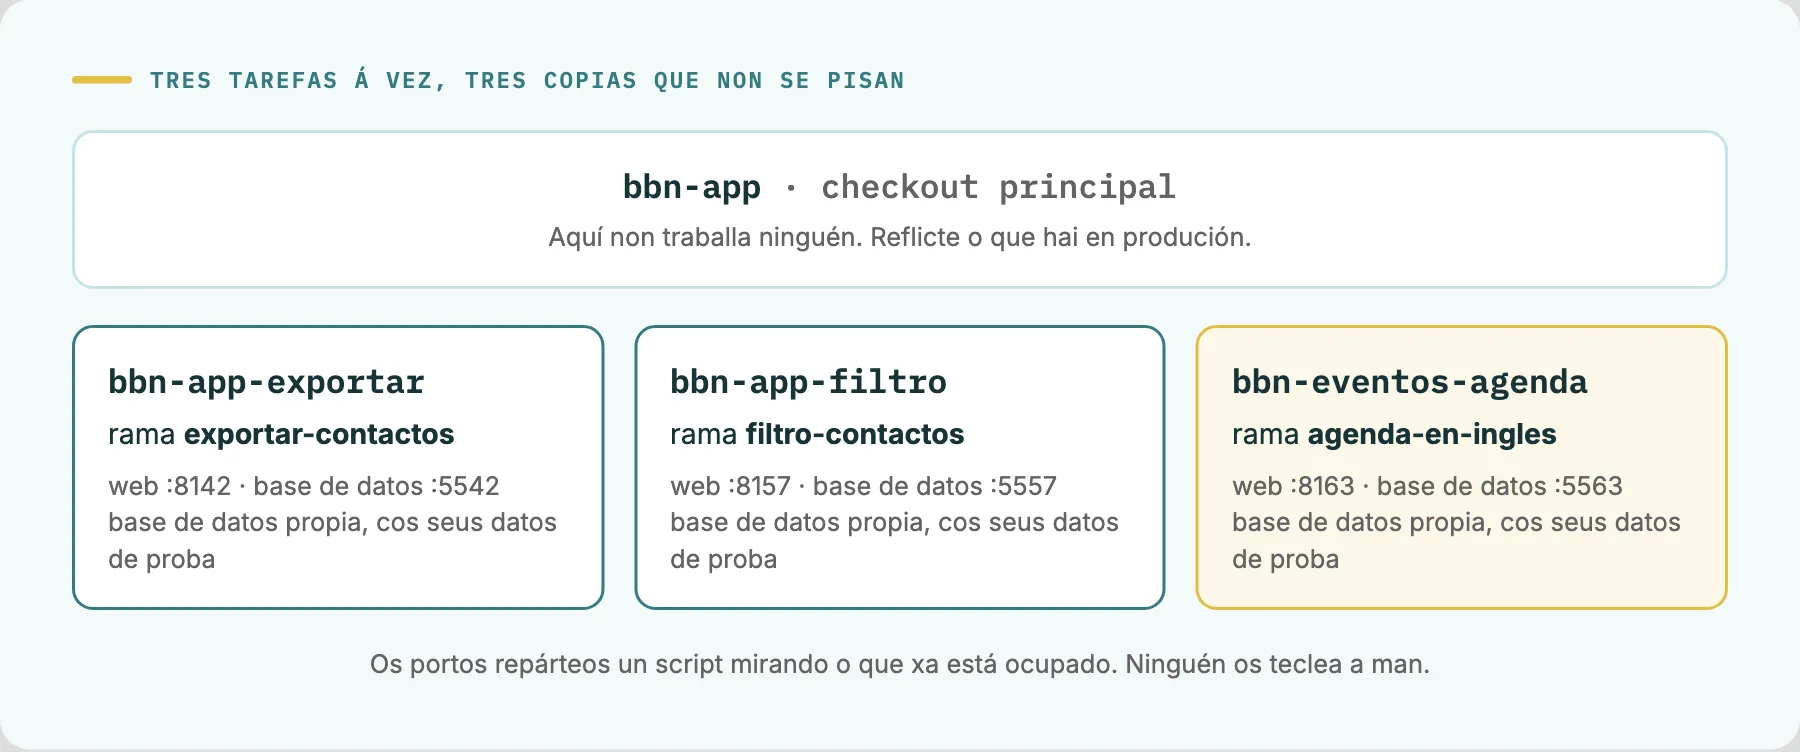
2. Cada tarefa na súa propia copia. Nunca se traballa no checkout principal, porque hai outras sesións en paralelo. Cada tarefa crea a súa copia de traballo (un worktree de git) coa súa rama, os seus portos e a súa propia base de datos. Os portos repárteos un script e ninguén os teclea a man. Dúas sesións sobre a mesma base de datos borraríanse os datos de proba a unha á outra, e faríano en silencio.
3. Primeiro o test que falla. Tanto no backend coma na interface. Un bug comeza sempre por un test que o reproduce e falla antes de tocar nada. Despois vén o código mínimo que o pon en verde.
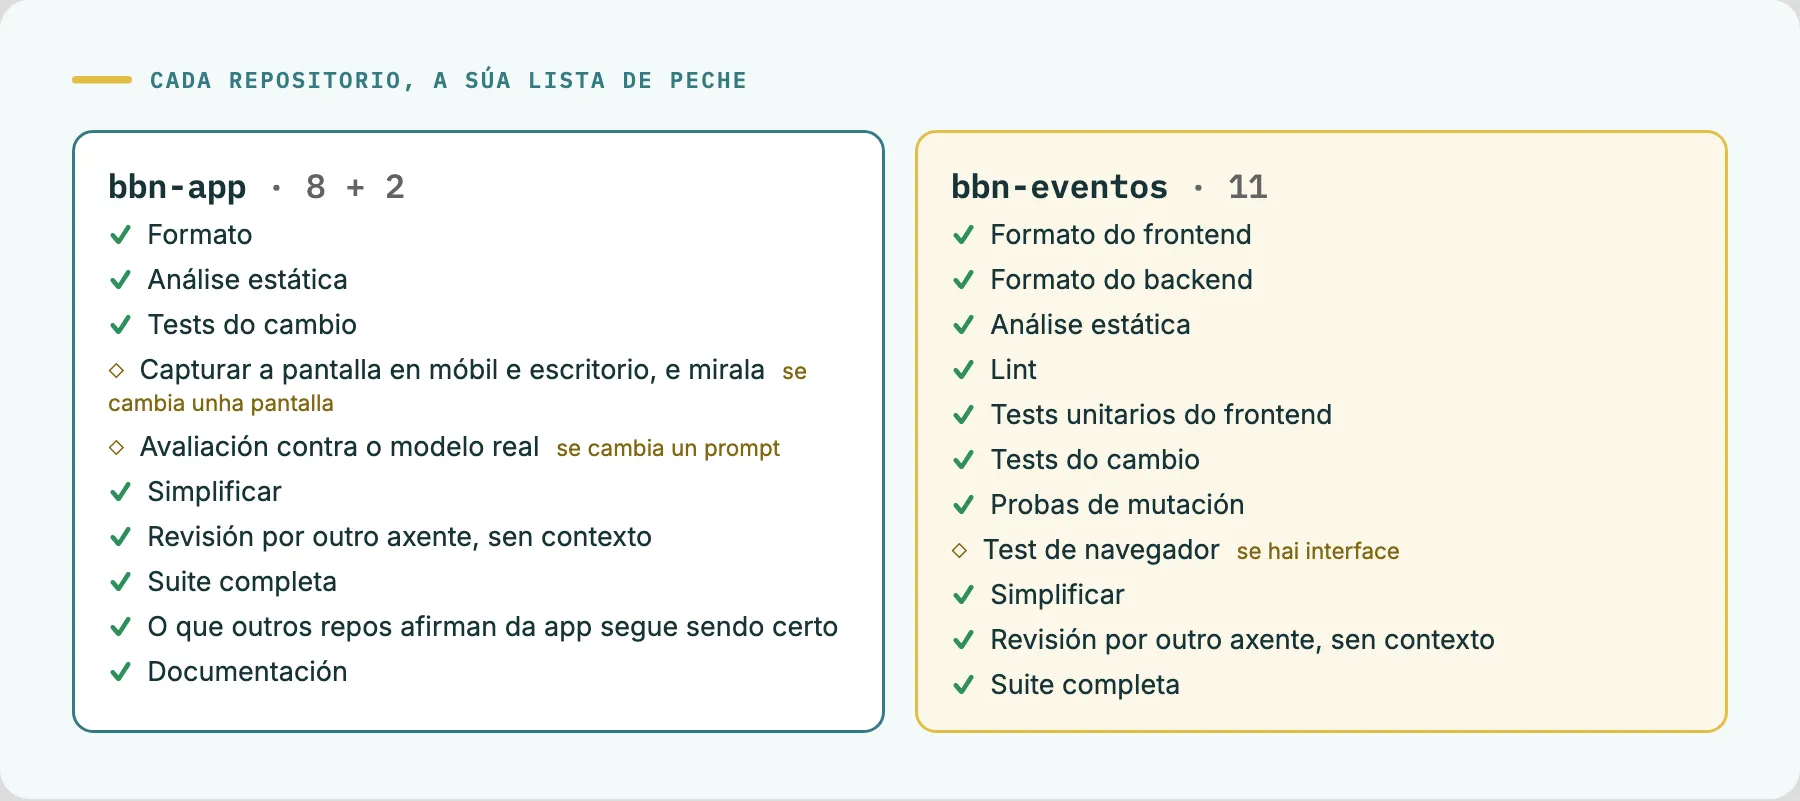
4. O peche obrigatorio de cada repositorio. Cada repositorio ten a súa lista de peche e non é opcional nin depende do tamaño do cambio. Na aplicación son oito pasos fixos: formato, análise estática, os tests do cambio, simplificar, revisión, a suite completa, comprobar que o que outro repositorio afirma sobre a aplicación segue sendo certo e actualizar a documentación. E dous máis que dependen do que toque a tarefa: se cambia unha pantalla, captúrase en móbil e en escritorio e mírase; se cambia un prompt, córrese a súa avaliación contra o modelo real. Na plataforma de eventos son once, entre eles o lint do frontend, os seus tests unitarios, probas de mutación e un test de navegador cando o cambio ten interface.
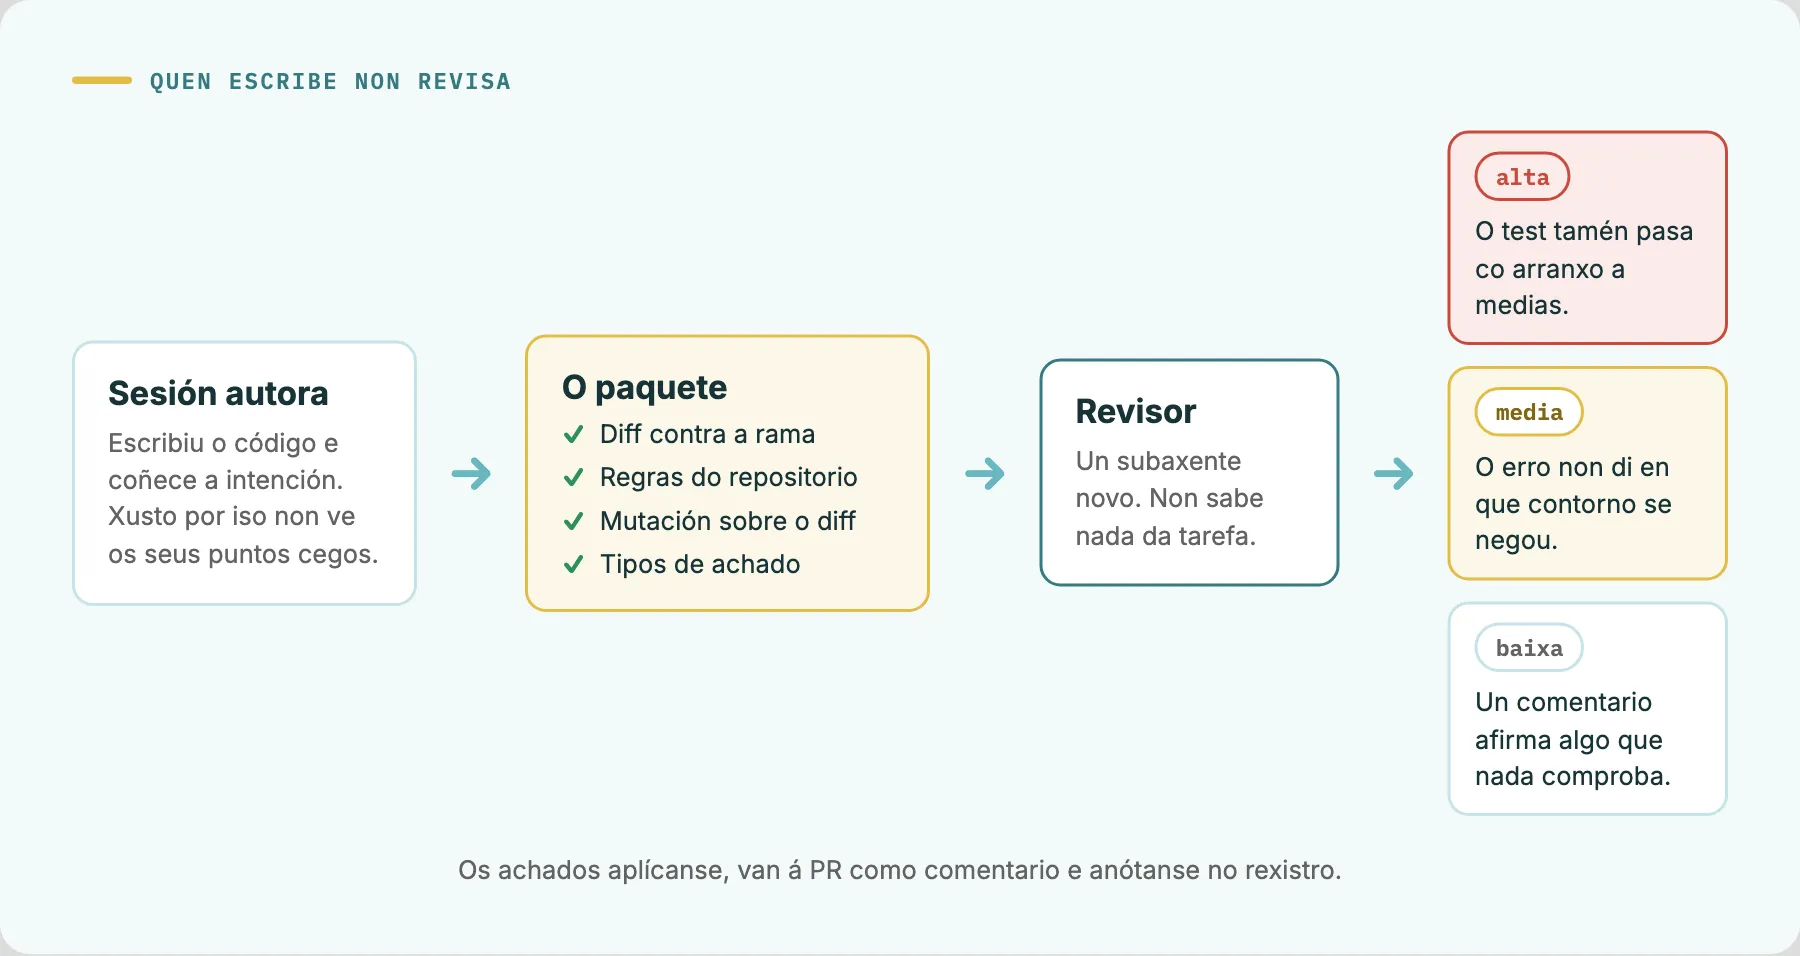
A revisión faina outro axente, sen o contexto de quen escribiu o código. É un subaxente que recibe un paquete co diff, as regras do repositorio e o resultado das probas, e devolve achados coa súa gravidade. Nunca o revisa a mesma sesión que o escribiu, porque quen escribe non ve os seus propios puntos cegos. E CI non repite a revisión: o que non ve o revisor non o ve ninguén.
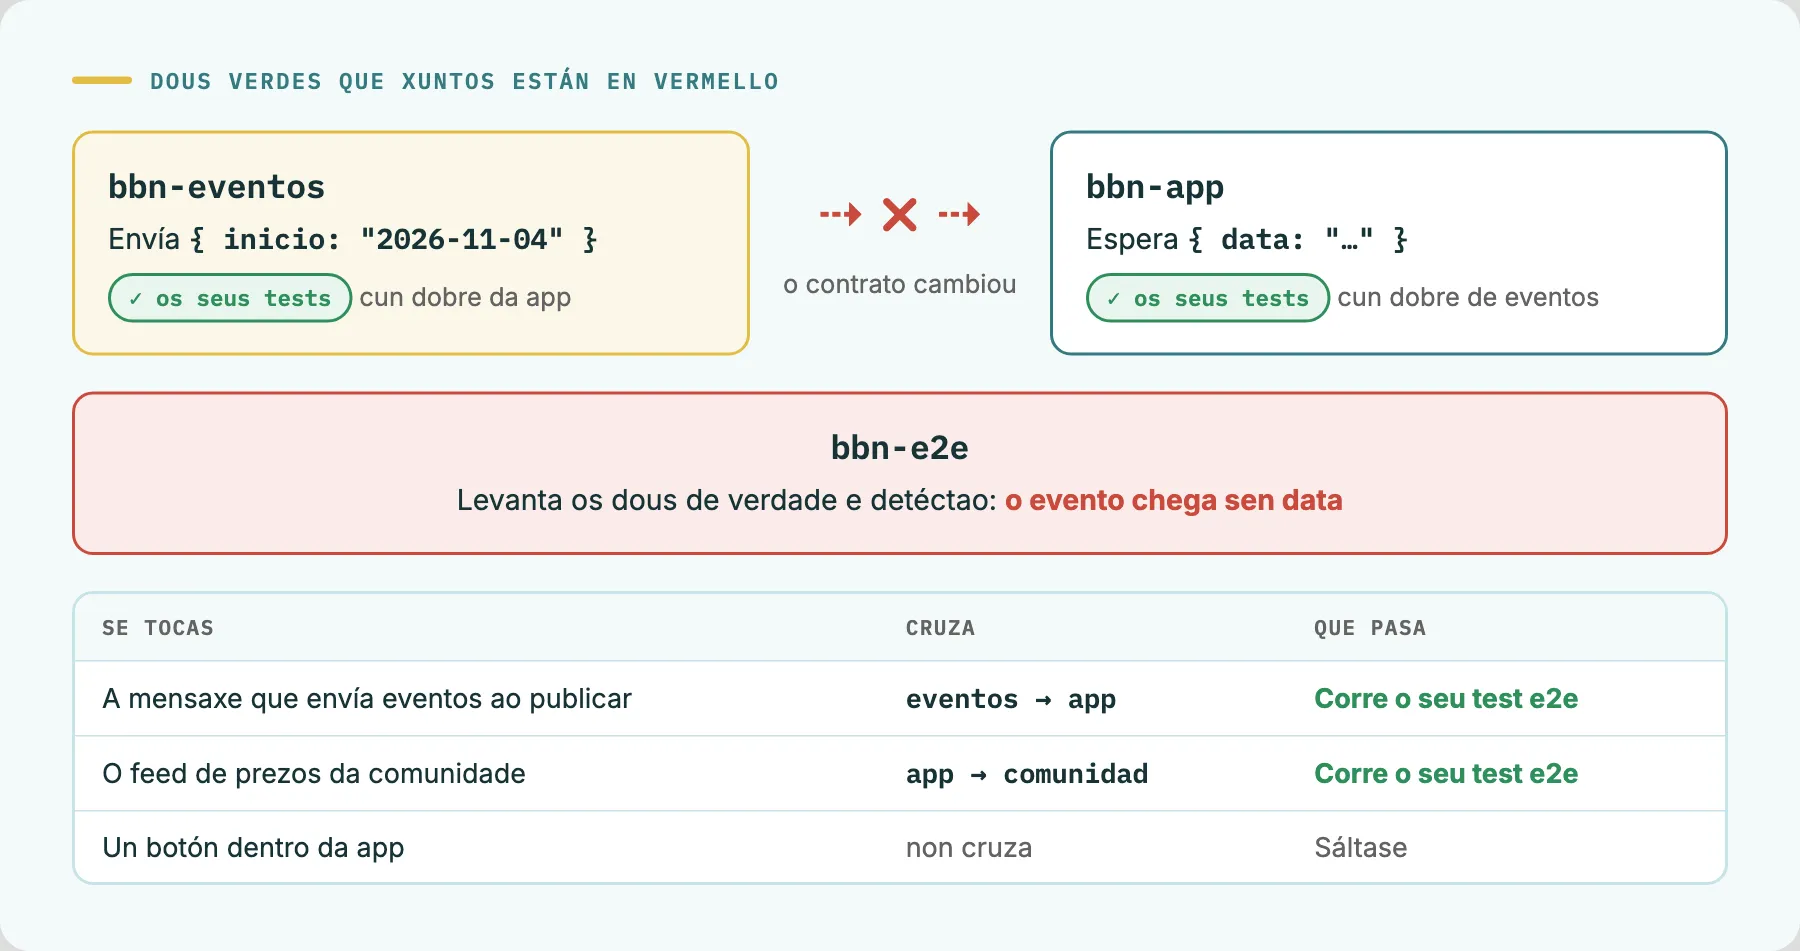
5. Probas entre repositorios, só cando fan falta. Cada repositorio proba a súa parte cun dobre do outro lado. Iso significa que dous repositorios poden pasar en verde co contrato entre eles roto. Para iso existe un repositorio de probas de extremo a extremo cunha táboa de costuras: se tocas a mensaxe que a plataforma de eventos envía á aplicación, rompe este fluxo e córrese este test. Se o cambio cae nunha costura, a tarefa actualiza ese test e córreo, ou di explicitamente que non puido correlo. Se non cae en ningunha, sáltase.
6. A PR. Ábrese en borrador, corre os tests repartidos en catro tandas en paralelo e, cando está en verde, pasa a lista. En vermello non se fai merge, e «en local pasaba» non conta como motivo.
7. O merge. Aquí está a garda máis traballada de todas, e ten a súa propia sección máis abaixo.
8. Produción. Facer merge é publicar: o merge a main desprega só. A tarefa dáse por pechada cando está en main, despregada en verde, e un script recolleu a copia de traballo, a súa base de datos e as súas ramas.
Hooks: regras que se cumpren soas
Claude Code permite configurar hooks: scripts que se executan en momentos fixos (ao arrancar unha sesión, despois de cada edición, antes de cada orde de terminal) e que poden bloquear o que vai pasar. Para nós son a diferenza entre unha regra escrita e unha regra que se cumpre.
Temos catro:
- Ao arrancar, o que pon os repositorios ao día e avisa dos fallos silenciosos.
- Despois de cada edición, o que formata o código e pasa o lint. Se a edición toca unha das gardas, corre ademais o test das gardas.
- Antes de cada orde de terminal, unha garda que bloquea o push directo a main nos repositorios de produto, calquera forma de destruír a base de datos de desenvolvemento fóra dunha copia de traballo, e as ordes que varrerían traballo sen gardar. Esta última só bloquea se de verdade hai algo que perder.
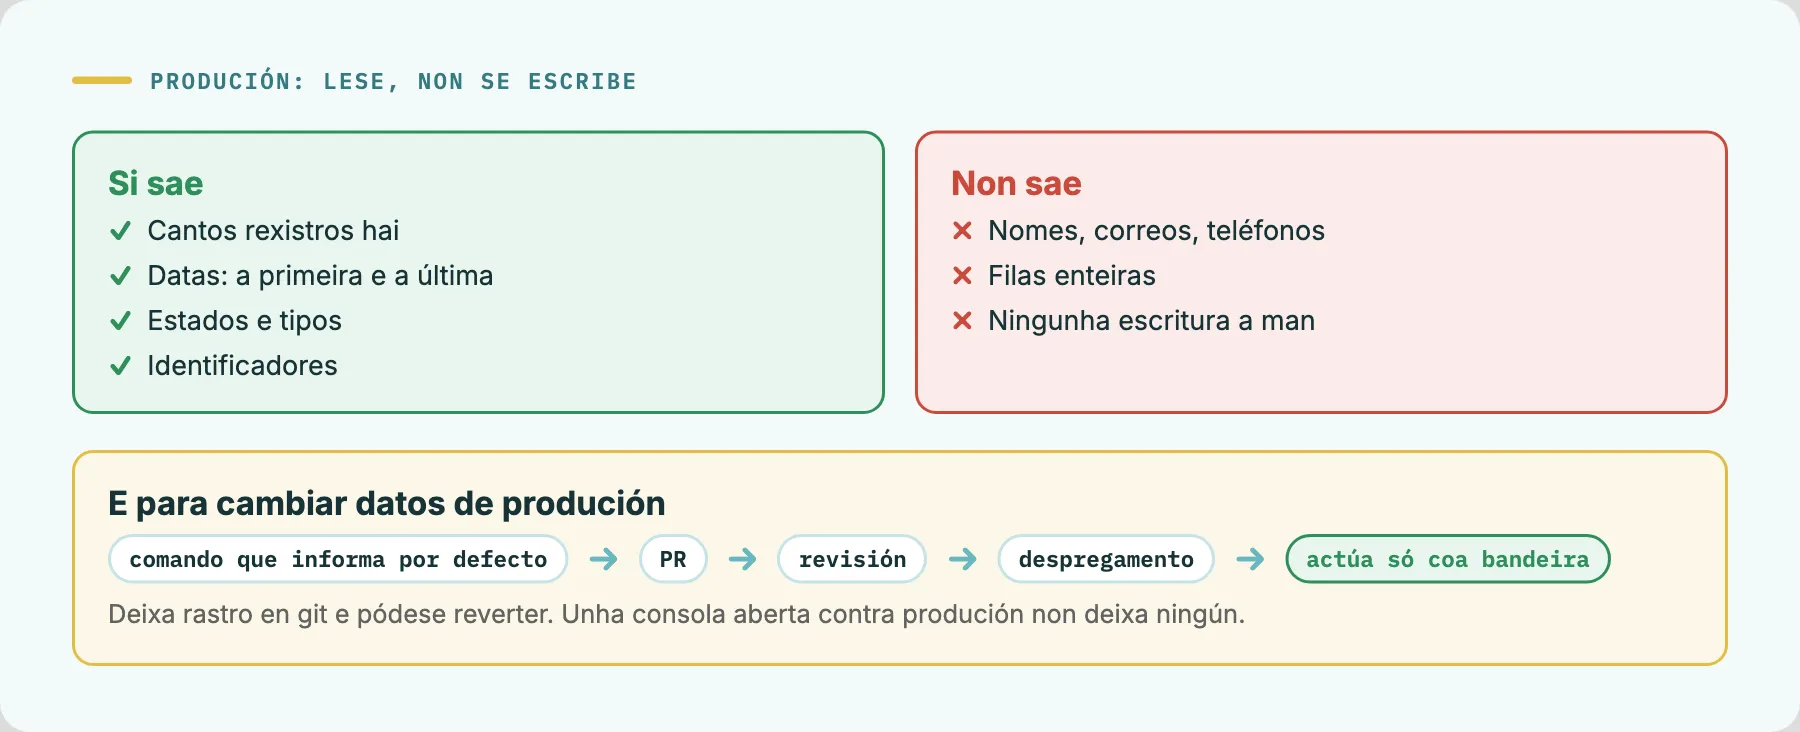
- Antes de cada orde de terminal, outra garda que deixa produción en só lectura. De alí só saen agregados (cantos, desde cando) e nunca campos con datos persoais.
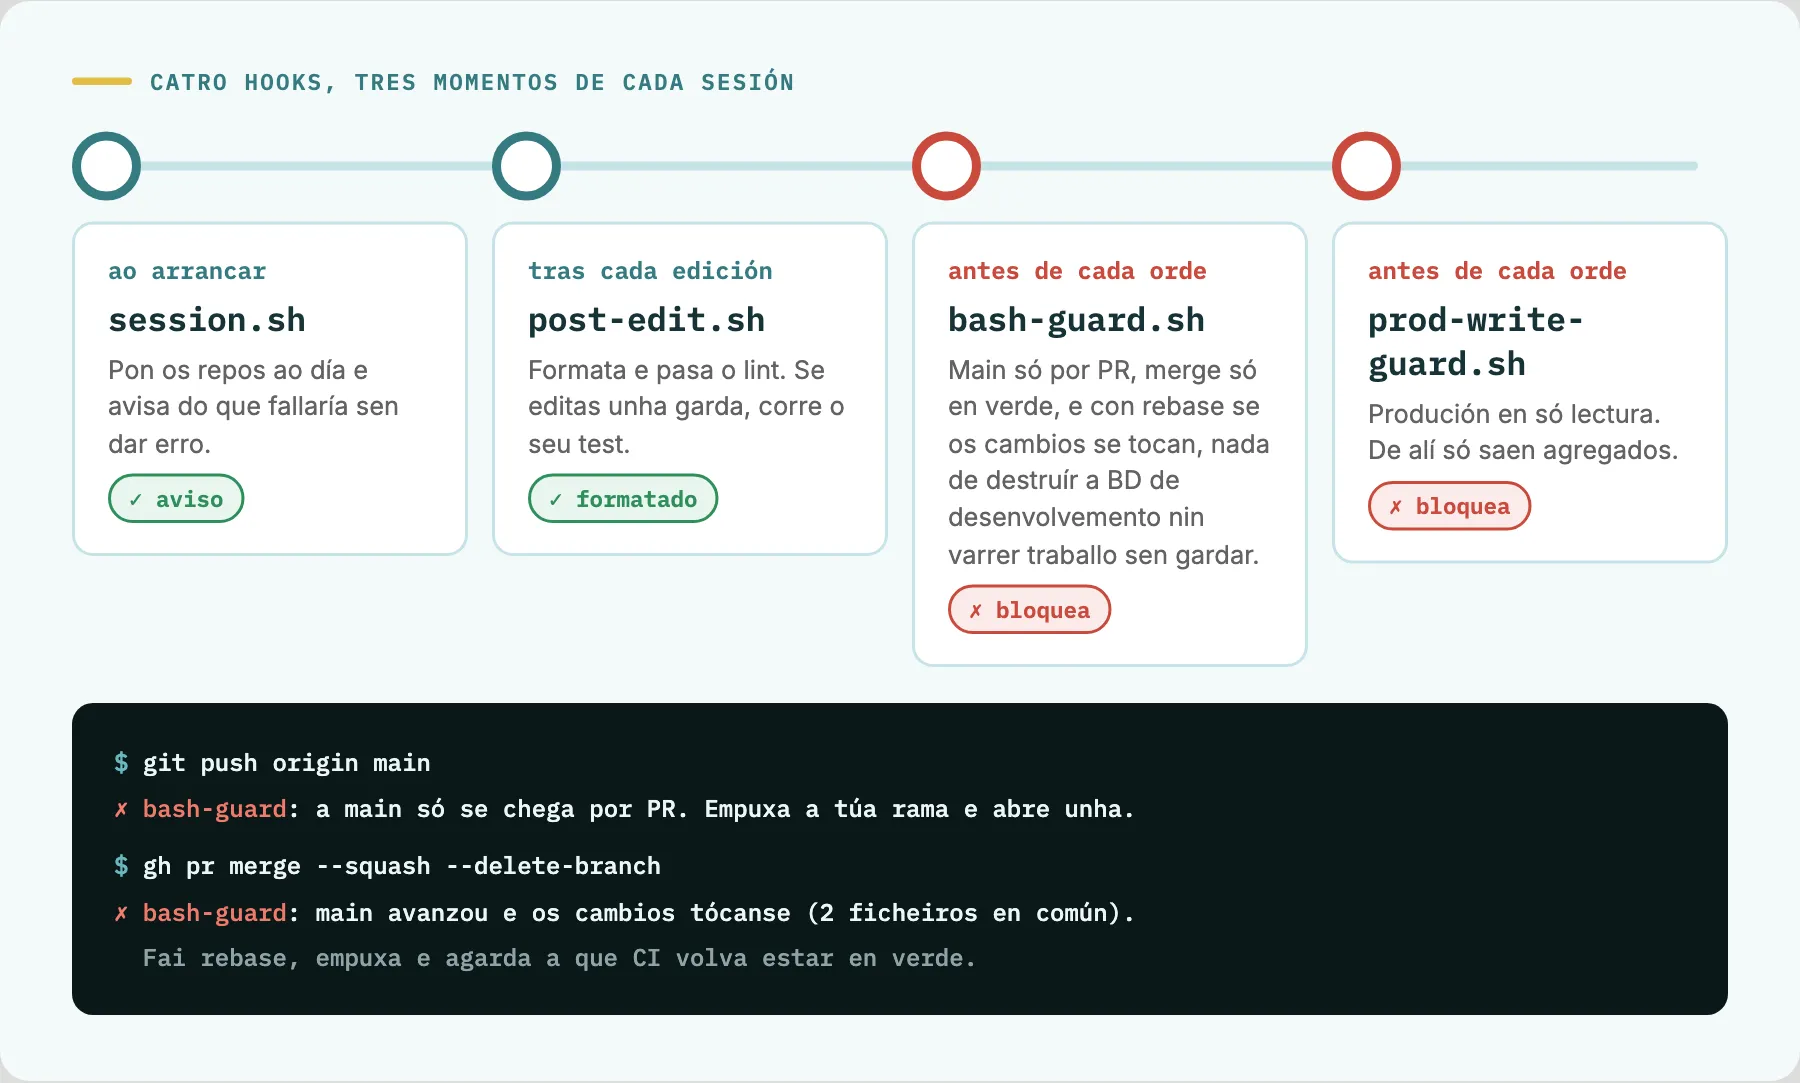
Os datos de produción pódense cambiar, pero só por un camiño: cun comando que por defecto só informa do que faría e unicamente actúa cunha bandeira explícita, chega nunha PR, revísase e desprégase. Custa unhas horas máis, pero deixa rastro en git e pódese reverter. Unha consola aberta contra produción só existe no historial dunha conversa.
As gardas seguen uns cantos principios que aprendemos a base de equivocarnos:
Sempre lista branca. Unha garda que enumera o perigoso protéxete do erro de onte. Unha que enumera o permitido protéxete tamén do de mañá. Aplicámolo igual dentro do código, por exemplo na comprobación que decide se un comando pode borrar datos:
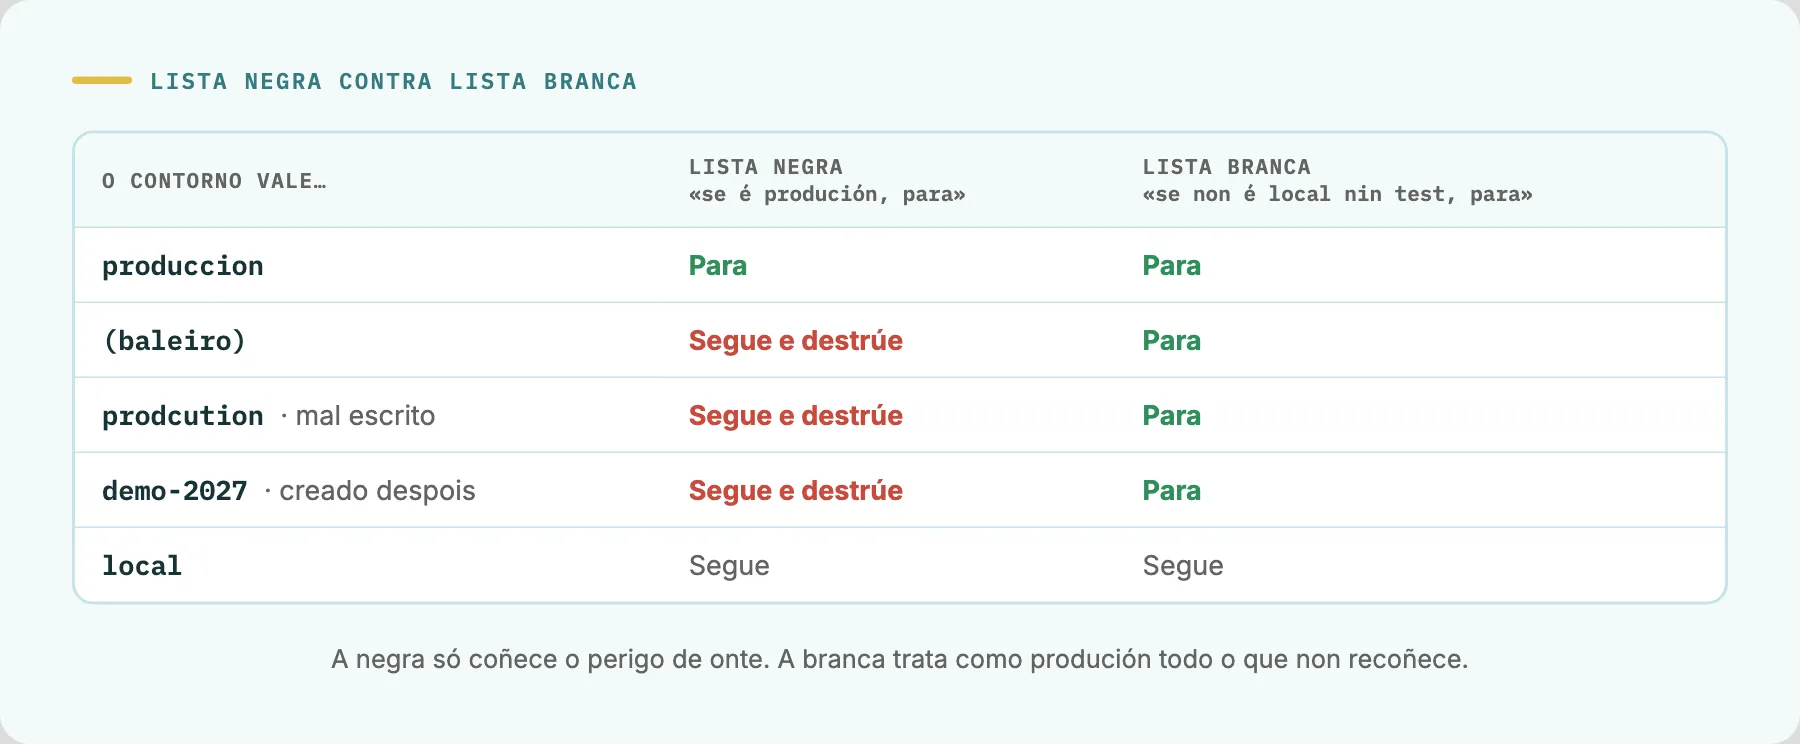
A lista negra deixa pasar, e destrúe, se a variable de contorno vén baleira, mal escrita ou co nome dun contorno creado despois. A branca trata como produción todo o que non recoñece.
Se non pode comprobar, bloquea. Se a unha garda lle falta unha ferramenta, non ten rede ou a máquina vai tan cargada que non chega a comprobar a tempo, non deixa pasar. Bloquea e di por que.
Unha garda que molesta acaba desactivada. Un falso positivo custa máis do que parece: a terceira vez que unha garda bloquea algo inofensivo, alguén busca a forma de apagala. Por iso o test das gardas comeza polos falsos positivos.
As gardas tamén teñen tests. Agora mesmo son 326 casos, cada un coa súa entrada e o resultado que se espera. Ademais, cada garda ten unha mutación: unha versión rota a propósito que o test ten que detectar. Se unha mutación sobrevive, falta un caso.
Cada hook ten que gañar o sitio. Só automatizamos un fallo cando cumpre dúas condicións: é silencioso (non dá erro, ou o erro fala doutra cousa) e unha máquina pode detectalo. Por iso non hai un hook que corra a suite enteira en cada edición, nin un que verifique o peche ao rematar cada sesión. O primeiro custaría minutos en cada cambio. O segundo tería tantos falsos positivos que o desactivariamos nunha semana.
O verde caduca
A garda do merge merece a súa propia sección, porque resolve o problema máis propio de traballar con varios axentes á vez.
Unha PR en verde está en verde respecto ao main que había cando correron os seus tests. Se mentres tanto outra tarefa fai merge por debaixo, ese verde xa non vale, e GitHub non volve correr os tests pola súa conta. Con varias sesións en paralelo, isto pasa todos os días.
Así que antes de cada merge a garda decide. Comproba que a PR está en verde e que o que se vai integrar é exactamente o que se probou. Despois mira se main avanzou. Se o que entrou e o que queres integrar tocan ficheiros distintos, deixa pasar. Se se tocan, ou se calquera dos dous cambia algo que altera o contorno dos tests (dependencias, configuración, migracións de base de datos, rutas), bloquea. Entón toca rebase, volver pasar CI e volver tentalo.
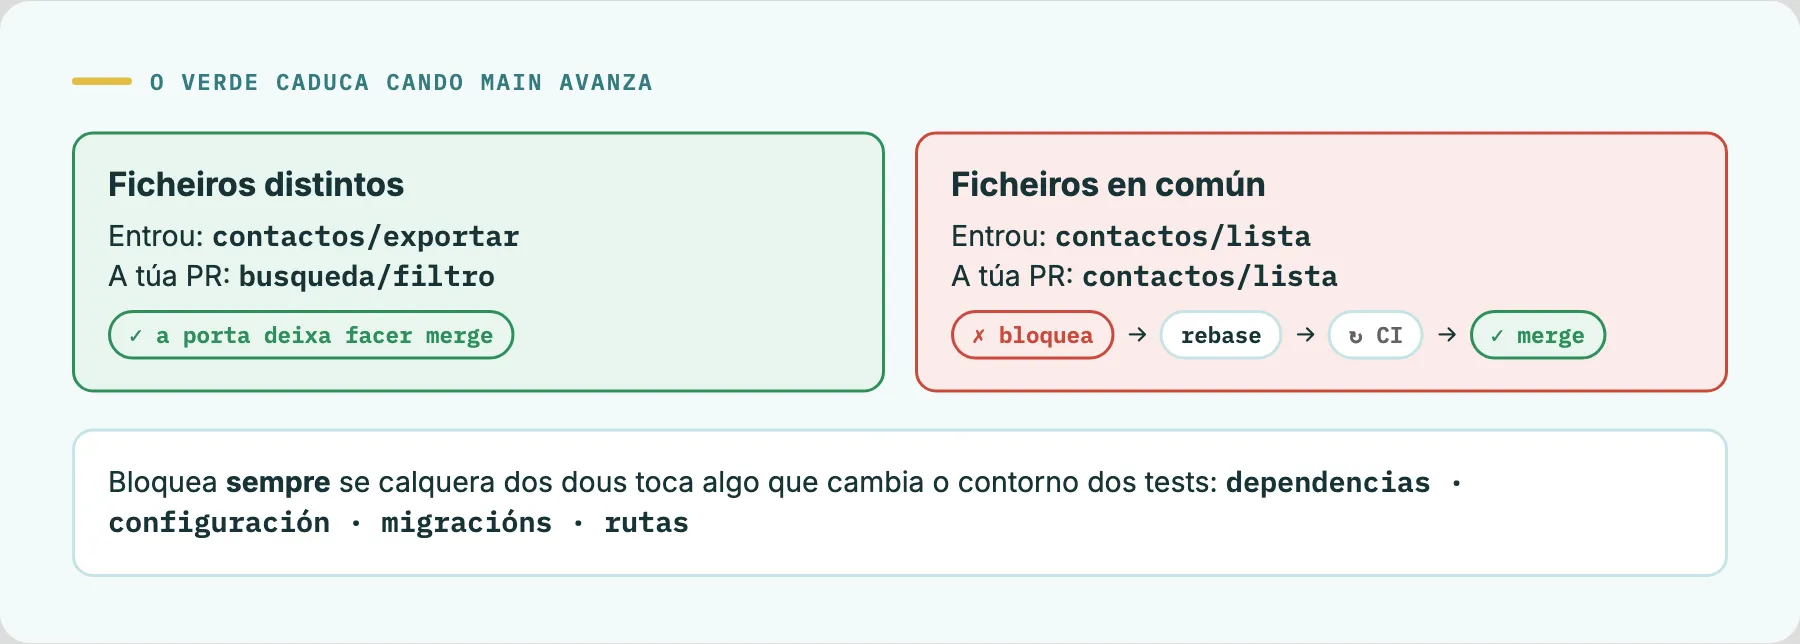
É o caso que se ve na animación: dúas tarefas no mesmo repositorio, a primeira entra, e a segunda atopa a porta pechada ata que se pon ao día.
Cada minuto de CI conta
Os minutos de GitHub Actions páganse, e con varias sesións empuxando á vez vanse moi rápido. Chegamos a quedar sen eles a metade de mes. Desde entón, cada peza de CI ten que xustificar o que custa, igual que as gardas.
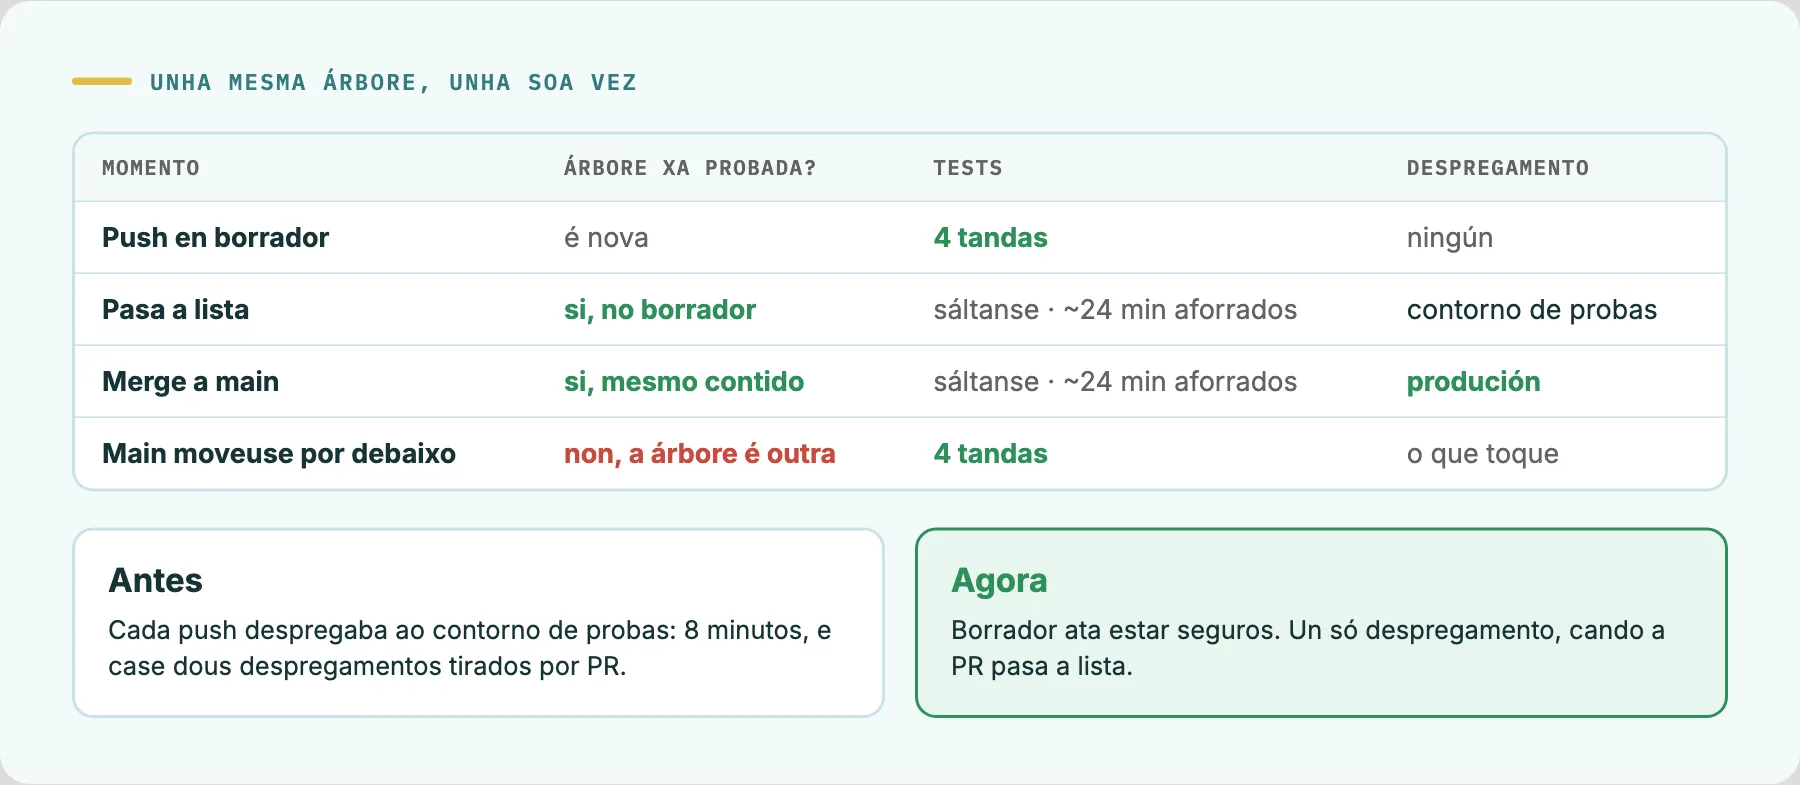
A PR nace en borrador e non pasa a lista ata que estamos seguros. En borrador corren os tests, pero non se desprega nada. Antes, cada push despregaba ao contorno de probas: uns 8 minutos por despregamento, e case dous despregamentos tirados por PR, porque o seguinte push deixábaos vellos. Agora a PR pasa a lista só cando o peche está feito e os tests do borrador están en verde. É entón, e só entón, cando desprega.
Unha árbore que xa pasou non se volve probar. Ao pasar a lista, GitHub lanzaba outra vez a suite enteira sobre o mesmo commit que o borrador acababa de aprobar. E ao facer merge, outra vez, sobre un commit novo co mesmo contido exacto. Agora o primeiro paso de CI mira o contido exacto que vai probar, sexa cal sexa a rama ou o commit, e pregunta se xa pasou todos os tests. Se a resposta é si, a suite sáltase, e son uns 24 minutos de runner cada vez. Se main cambiou por debaixo, a árbore é outra e os tests corren, como debe ser.
Non usamos a cola de merge de GitHub. Resolvería a carreira entre PRs que tocan o mesmo, pero volve correr CI para cada PR que entra na cola. E a alternativa habitual, esixir que a rama estea ao día con main, obriga a rebase e suite completa cada vez que main se move, aínda que o que entrou non teña nada que ver. A porta que contamos antes fai o mesmo traballo pedindo só o necesario: se os cambios non se tocan, o verde vale; se se tocan, outra volta.
Mutación, só sobre o que cambia. As probas de mutación meten pequenos erros a propósito e comproban se os tests se decatan. Na aplicación mutabamos os ficheiros enteiros que tocaba cada cambio, case dez minutos por tarefa. Agora cada tarefa muta só o que o seu cambio engade: quita cada condición nova, unha a unha, e comproba que algún test cae. Tarda segundos. Tamén apagamos a medición semanal do código enteiro: custaba miles de minutos de CI ao mes e case nunca chegaba ao final. Na plataforma de eventos, onde mutar os ficheiros tocados custa menos dun minuto, esa pasada segue ademais dentro do peche.
E o que se pode romper, mellor rompelo en local. Cada push en vermello é outro pipeline completo. O peche obrigatorio existe tamén por iso: o que atopa en local non gasta nin un minuto de CI.
O bucle que aprende
Todo o anterior evita os erros que xa coñecemos. Pero os que máis doen son os novos, e para eses hai un bucle con dúas entradas.
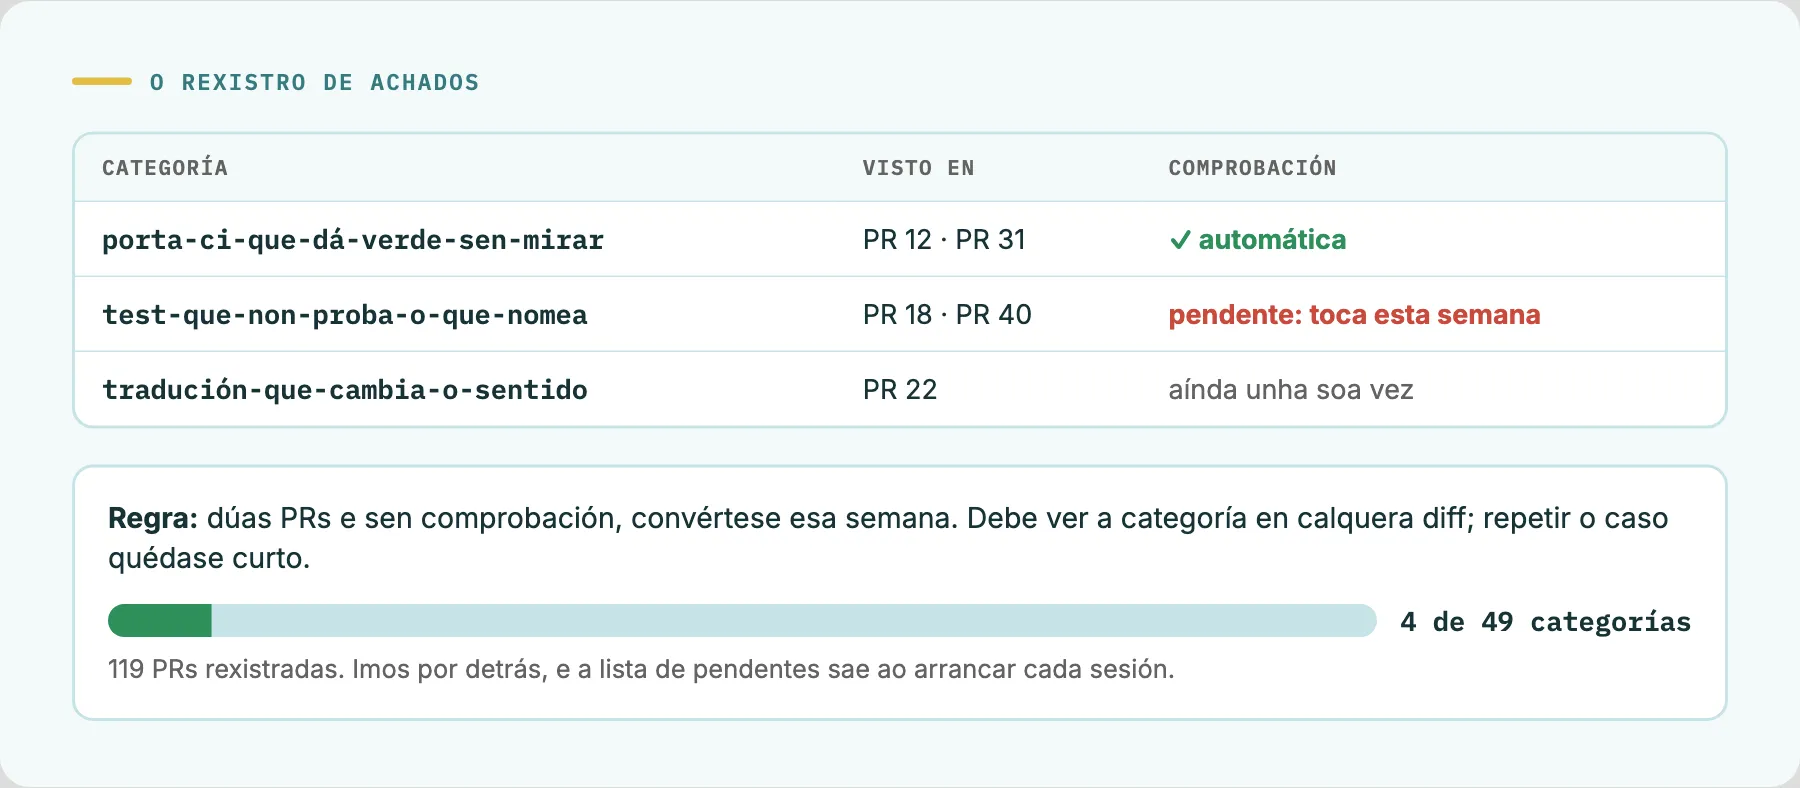
Os achados das revisións. Cada achado do revisor de peche anótase nun rexistro cunha categoría: «test que non proba o que di», «fallo que sae en silencio», «tradución que cambia o sentido». A regra é que unha categoría que aparece en dúas PRs e aínda non ten comprobación automática convértese nunha esa mesma semana. Esa comprobación ten que detectar a categoría en calquera diff; repetir o test do caso que a destapou quédase curto.
Hai que ser sinceros cos números. Levamos 119 PRs rexistradas, 49 categorías distintas, e só 4 se converteron xa en comprobación automática. Escribir unha comprobación que vexa unha categoría enteira sen dar falsos positivos é difícil, e unha mala comprobación é peor que ningunha. O que si está automatizado é o recordatorio: cada sesión arranca coa lista de categorías pendentes diante.
Os incidentes. Con todo isto, as cousas seguen rompendo. Case sempre por algún destes motivos:
- O que non dá erro. Unha configuración que apunta ao contorno equivocado, un test que pasa sen probar nada ou un dato que se calcula sobre unha fonte que xa non existe. Todo en verde, e todo mal.
- Dous cambios correctos que xuntos non o son. Cada PR pasa os seus tests por separado e o problema só aparece cando conviven en main.
- O que só pasa nun contorno. As probas locais e CI usan bases de datos distintas, e o que unha tolera, a outra rexéitao. Ou unha variable que ninguén fixou e que na túa máquina vale outra cousa.
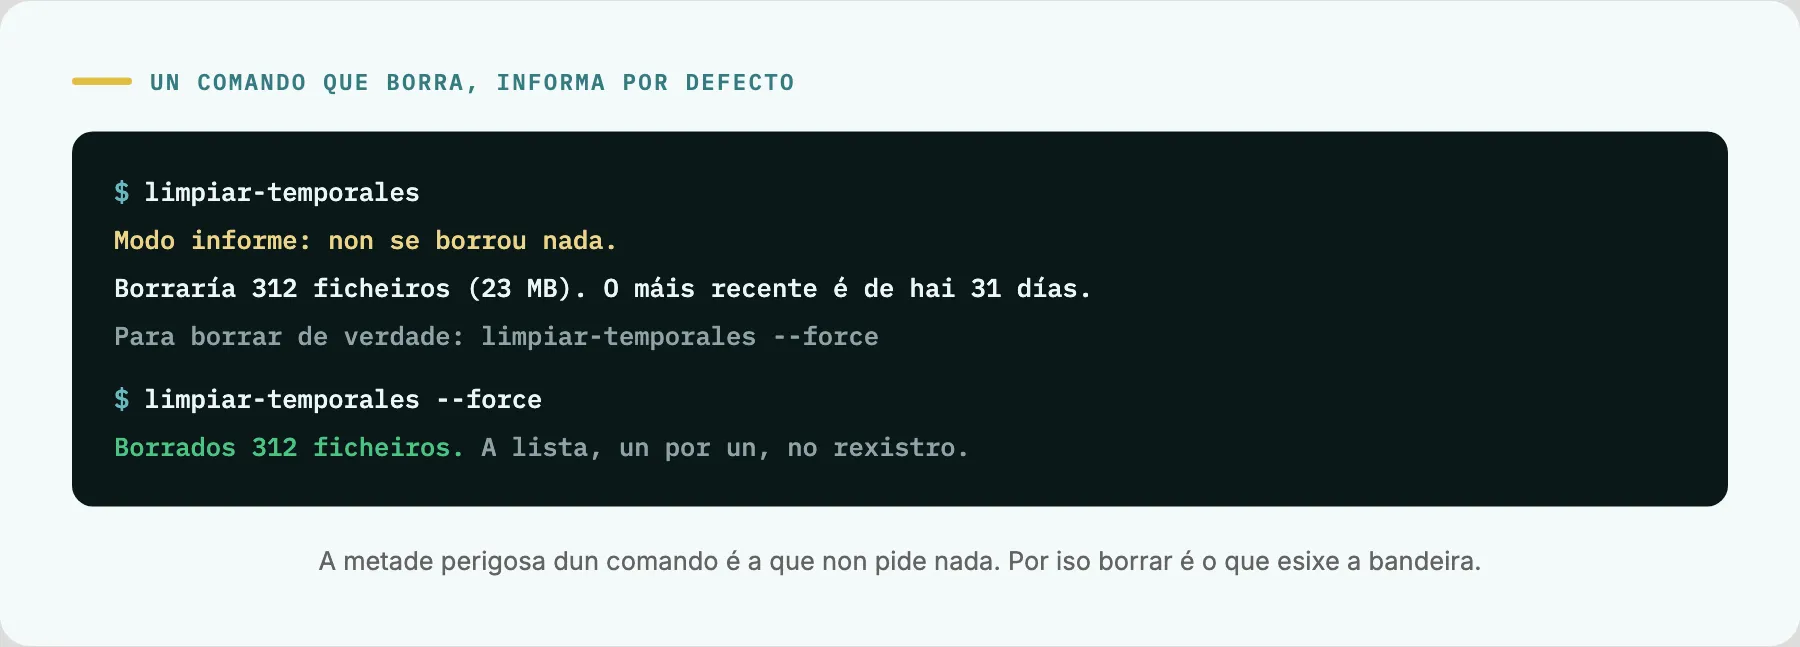
- Os comandos cuxa metade perigosa é a que non pide nada. Un comando que borra cando o executas sen argumentos é unha trampa agardando por alguén con présa. Por iso todo comando que borra, trunca ou sobrescribe datos informa por defecto e só actúa cunha bandeira explícita.
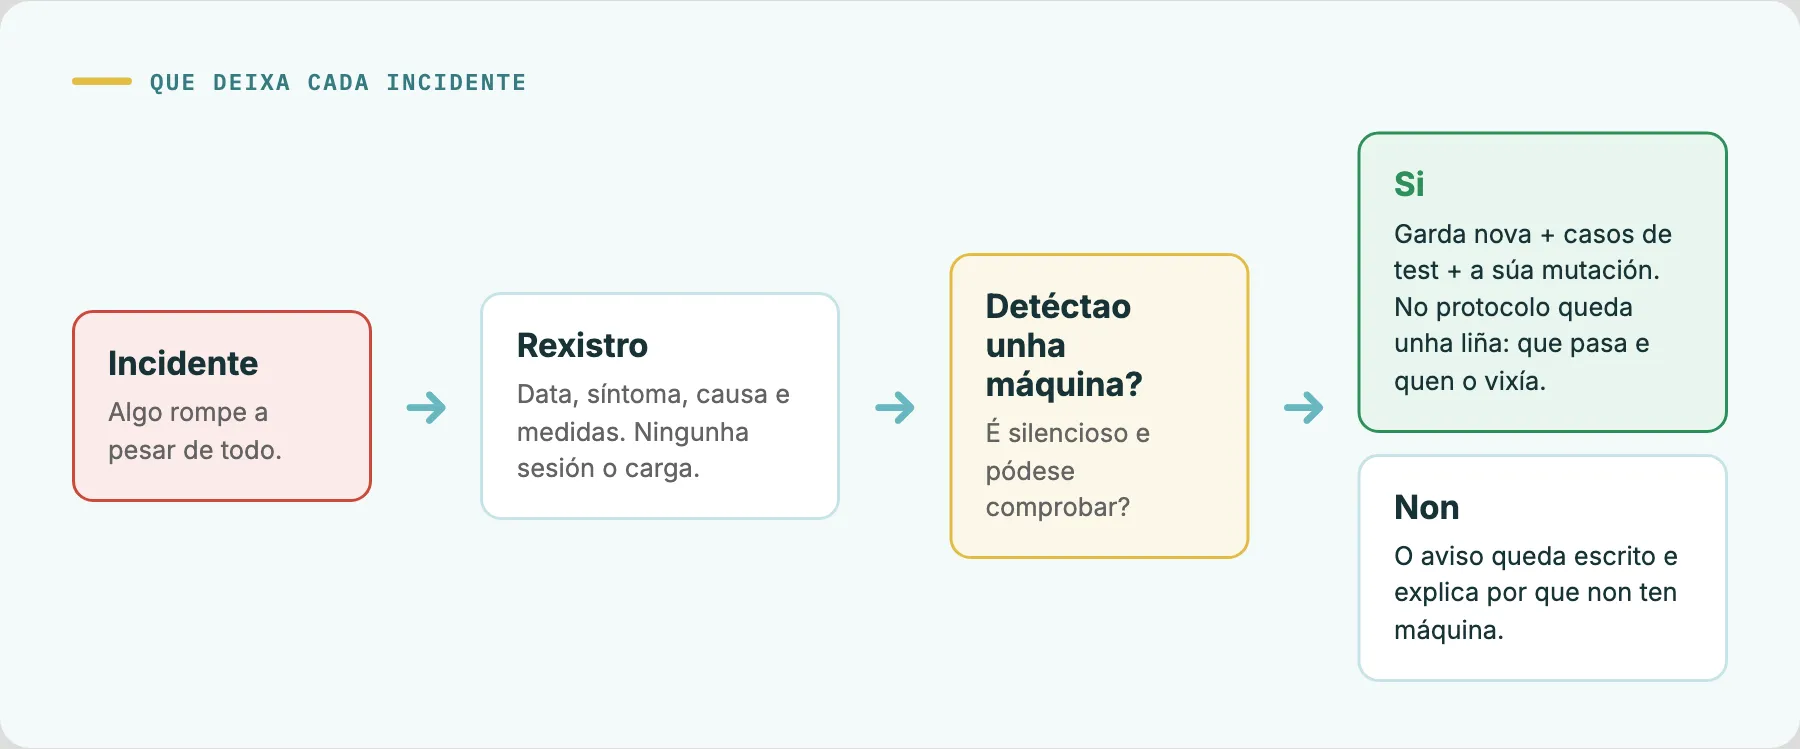
Cada incidente anótase coa súa data, o seu síntoma, a súa causa e as medidas tomadas. Se unha máquina pode detectalo, convértese nunha garda cos seus casos de test e a súa mutación, e no protocolo queda unha soa liña. Se non pode, o aviso queda escrito e explica por que non ten máquina detrás.
É isto unha software factory?
Agora todo o mundo fala de software factories: axentes que reciben unha idea por un lado e entregan software rematado polo outro. A pregunta é inevitable, e a resposta curta é que só en parte.
Hai cousas que si son de fábrica. Hai unha liña con estacións fixas, e cada repositorio ten a súa. As gardas fan o que nunha planta fan os sistemas a proba de erros: fan que o fallo non poida ocorrer. A liña párase soa cando algo vai mal, cun CI en vermello ou un merge que choca con outro. E hai mellora continua, porque cada erro que se repite ten que acabar convertido nunha comprobación.
Pero hai outras que non. Que se constrúe, cando comeza unha tarefa e se está ben formulada seguímolo decidindo nós. Non hai unha cola que se procese soa desde o backlog ata produción. E a mellora continua vai por detrás, como contan eses 4 de 49.
Por iso preferimos outro nome para o que construímos: o control de calidade dunha fábrica de software. Os axentes producen e a liña decide que pasa.
O que levamos
- O contexto é orzamento. Un protocolo que ninguén le non protexe de nada. É mellor unha liña cunha máquina detrás ca un parágrafo ben escrito.
- Quen escribe non revisa. Un revisor sen contexto atopa o que o autor xa non pode ver, sexa unha persoa ou un axente.
- Máquinas antes que memoria. Todo o que se pode comprobar compróbase só, e todo o que non, escríbese co seu porqué.
- Non todo merece unha máquina. Unha comprobación que custa minutos en cada cambio, ou que molesta máis do que protexe, acaba desactivada. Cada peza ten que pagarse no tempo que aforra.
Traballar así dános tranquilidade. A maior parte do que podería saír mal párase antes de chegar a produción, e o que chega deixa algo aprendido para a próxima vez.
Se tamén traballas con axentes e queres comparar notas, escríbenos. Encántanos falar disto.
