Deu repositoris, uns quants agents i cap ensurt: així treballem amb Claude Code

BlaBlaNote és un equip petit amb deu repositoris: l’aplicació, la plataforma d’esdeveniments, el motor de matchmaking, el web, la comunitat, l’extensió del navegador, la documentació, les proves d’extrem a extrem, el compliment legal i un més que no desplega res. Tot el codi l’escriu Claude Code, sovint amb diverses sessions alhora i de vegades amb dues al mateix repositori. I despleguem a producció diverses vegades al dia.
Amb un equip així, el que importa és aconseguir que no es trenqui res mentre s’escriu tant de codi.
Un agent no es cansa, però comença cada sessió sense recordar què va passar la setmana anterior. Una persona sí que se’n recorda, durant unes setmanes. Per això la regla que ho ordena tot és fàcil de dir i força més difícil de complir: cap regla important pot dependre que algú se’n recordi.
Aquest article explica com ho fem. Són tres peces: un repositori que guarda les regles, uns hooks que les fan complir i un bucle que converteix cada error en una comprovació nova.
El repositori que no desplega res
El desè repositori es diu planning. No té codi de producte. Guarda el protocol de treball que llegeixen totes les sessions, els plans de cada front obert, els hooks i els registres d’incidents i de troballes.
Viu a part per un motiu pràctic. Si el protocol fos dins de l’aplicació, cada branca tindria la seva pròpia còpia i cada còpia aniria per lliure. Separat, sobreviu a qualsevol branca i a qualsevol còpia de treball, i totes les sessions arrenquen des d’ell amb els repositoris de producte al costat.
Els plans porten el seu estat al principi. Cada plan comença amb una línia Estat: i un índex els agrupa per front i diu quin mana a cadascun. Una sola ordre treu l’estat de tots, així que abans de donar una cosa per pendent o per feta es pot comprovar en segons. Un plan nou sense la seva línia d’estat o sense la seva entrada a l’índex genera un avís automàtic.
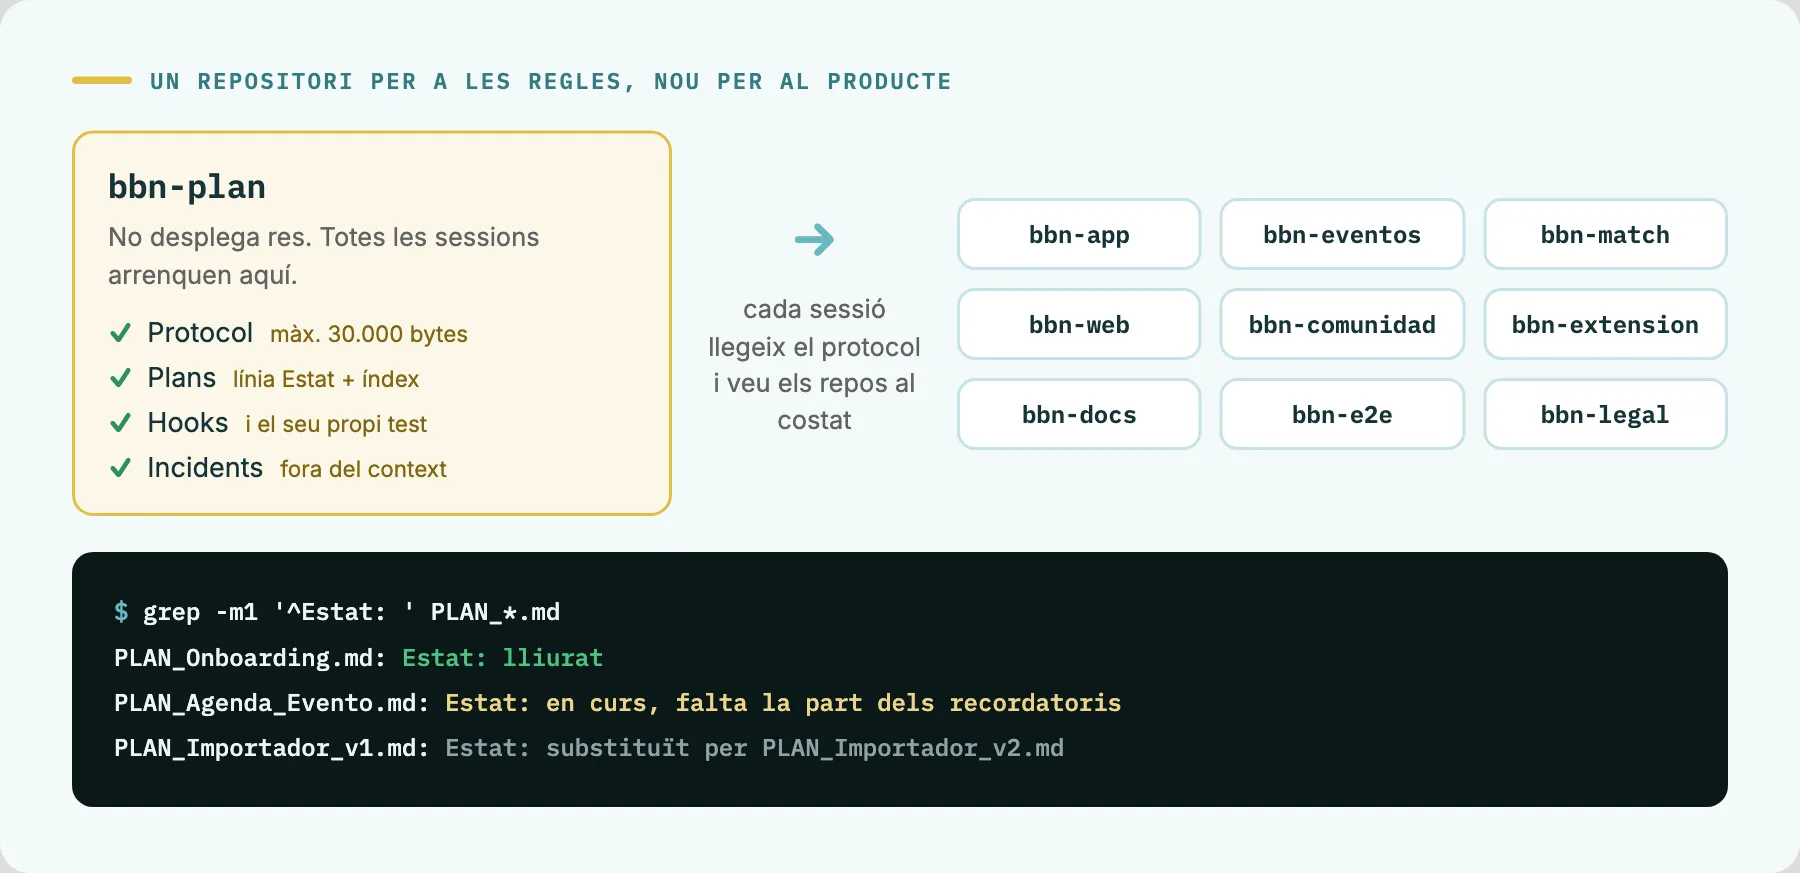
El protocol té pressupost. Té un límit de 30.000 bytes, i passar-se’n dona un avís. Sembla un detall i és el més important de tot el repositori. Cada sessió de Claude Code carrega el protocol sencer al seu context, i un protocol que creix sense límit acaba com qualsevol manual llarg: ningú no el llegeix de debò. La regla de poda és aquesta: tot avís que ja té una màquina al darrere es redueix a una línia que diu què passa i qui ho vigila. La història completa (data, símptoma, causa, mesures) va a un fitxer d’incidents que cap sessió no carrega.
Una tasca, de principi a fi
Així fa una tasca el camí fins a producció.
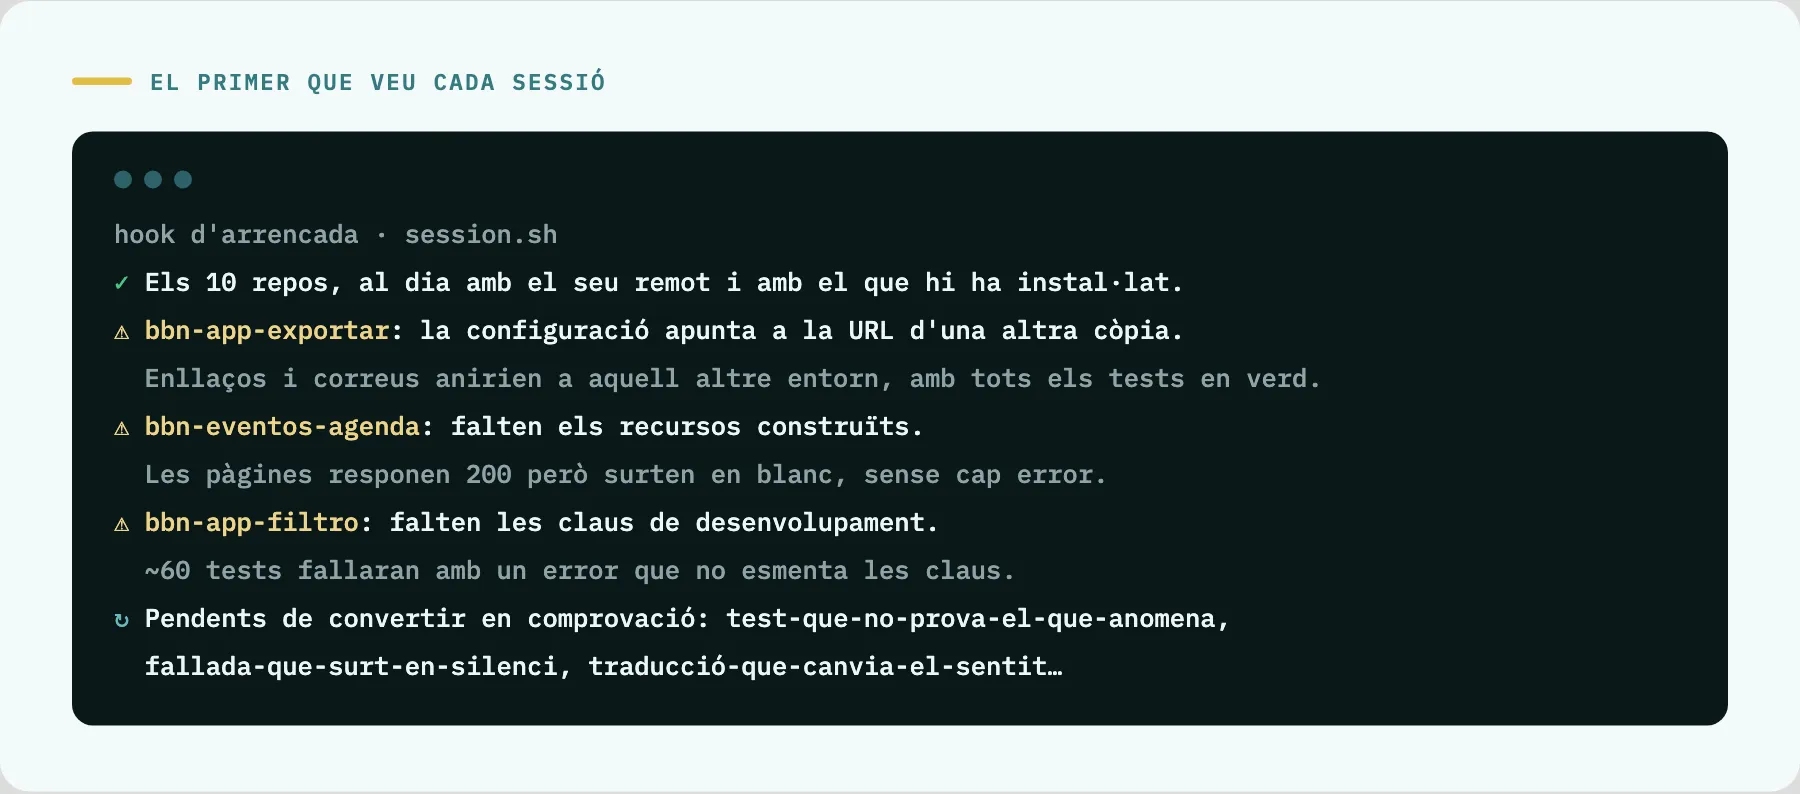
1. Començar amb tot al dia. En començar la sessió, un hook porta els canvis dels deu repositoris i compara cadascun amb el seu remot i amb el que té instal·lat. Llegir codi vell no dona cap error: ni en llegir-lo ni en mirar-ne l’historial. A més, el hook revisa cada còpia de treball i avisa del que fallaria sense dir res, com una configuració que apunta a l’entorn d’una altra còpia o uns recursos sense construir. Són fallades que acaben en tests verds que no proven res, o en correus que surten cap al lloc equivocat.
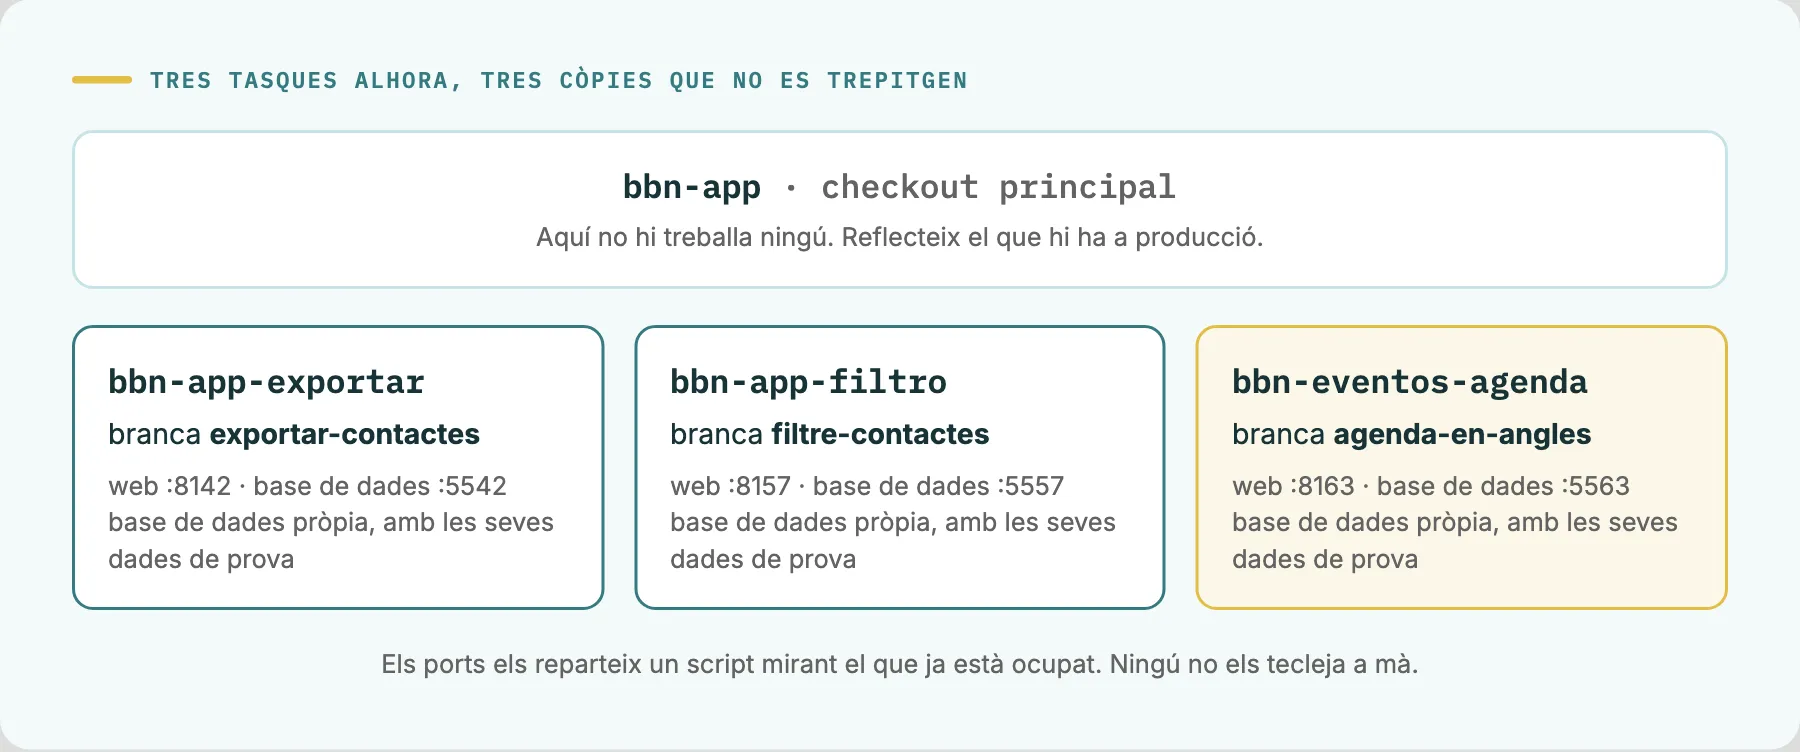
2. Cada tasca a la seva pròpia còpia. Mai no es treballa al checkout principal, perquè hi ha altres sessions en paral·lel. Cada tasca crea la seva còpia de treball (un worktree de git) amb la seva branca, els seus ports i la seva pròpia base de dades. Els ports els reparteix un script i ningú no els tecleja a mà. Dues sessions sobre la mateixa base de dades s’esborrarien les dades de prova l’una a l’altra, i ho farien en silenci.
3. Primer el test que falla. Tant al backend com a la interfície. Un bug comença sempre per un test que el reprodueix i falla abans de tocar res. Després ve el codi mínim que el posa en verd.
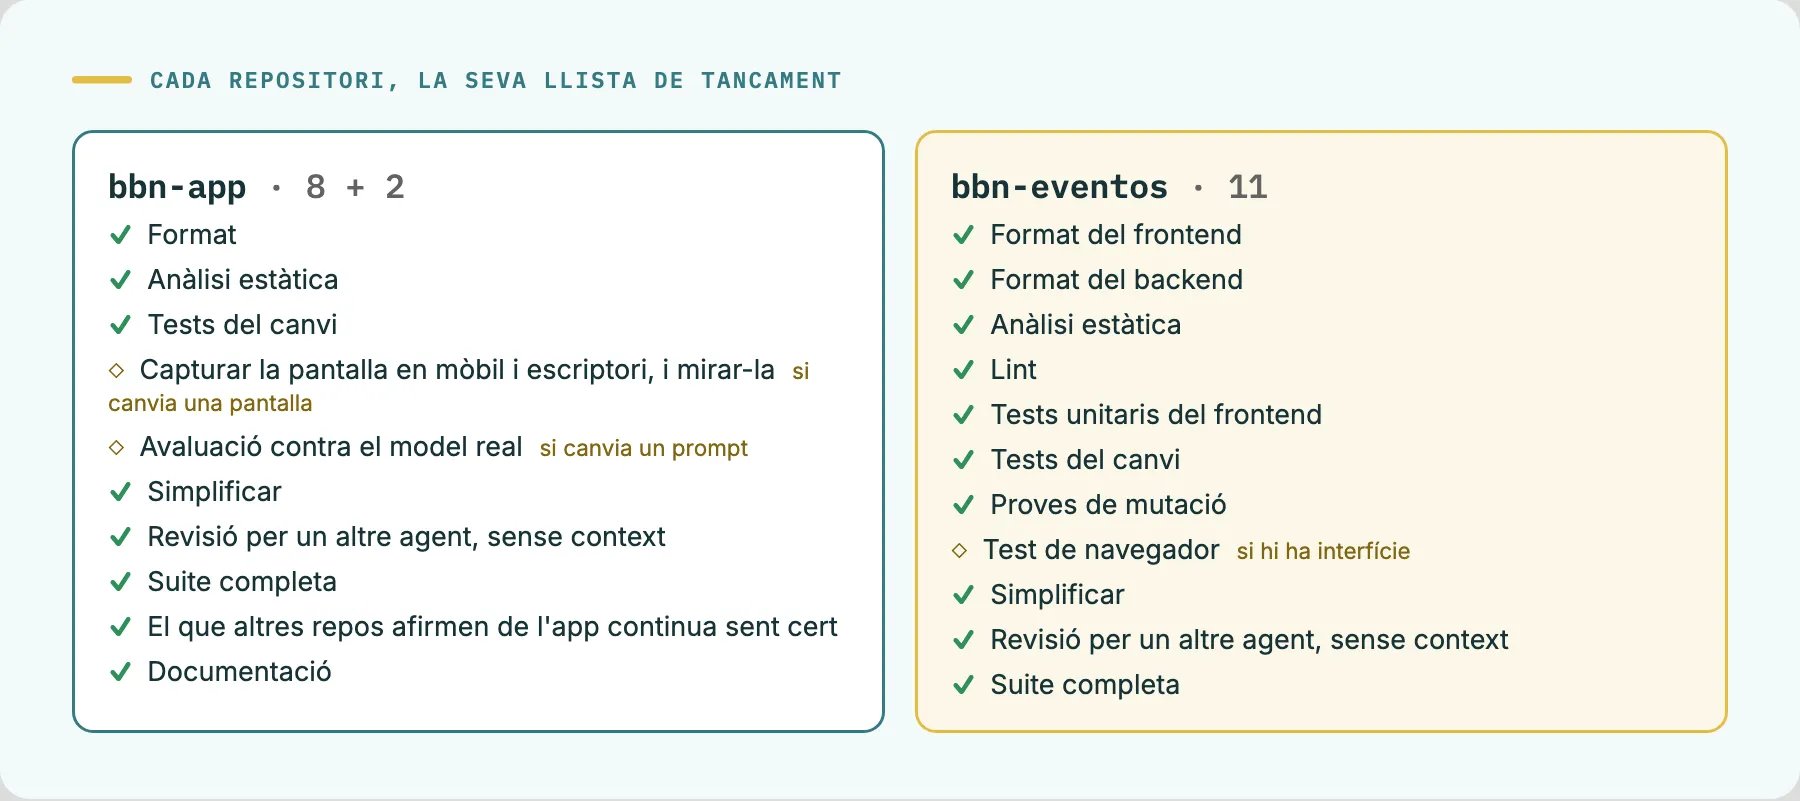
4. El tancament obligatori de cada repositori. Cada repositori té la seva llista de tancament, i no és opcional ni depèn de la mida del canvi. A l’aplicació són vuit passos fixos: format, anàlisi estàtica, els tests del canvi, simplificar, revisió, la suite completa, comprovar que el que un altre repositori afirma sobre l’aplicació continua sent cert i actualitzar la documentació. I dos més que depenen del que toqui la tasca: si canvia una pantalla, es captura en mòbil i en escriptori i es mira; si canvia un prompt, es passa la seva avaluació contra el model real. A la plataforma d’esdeveniments són onze, entre ells el lint del frontend, els seus tests unitaris, proves de mutació i un test de navegador quan el canvi té interfície.
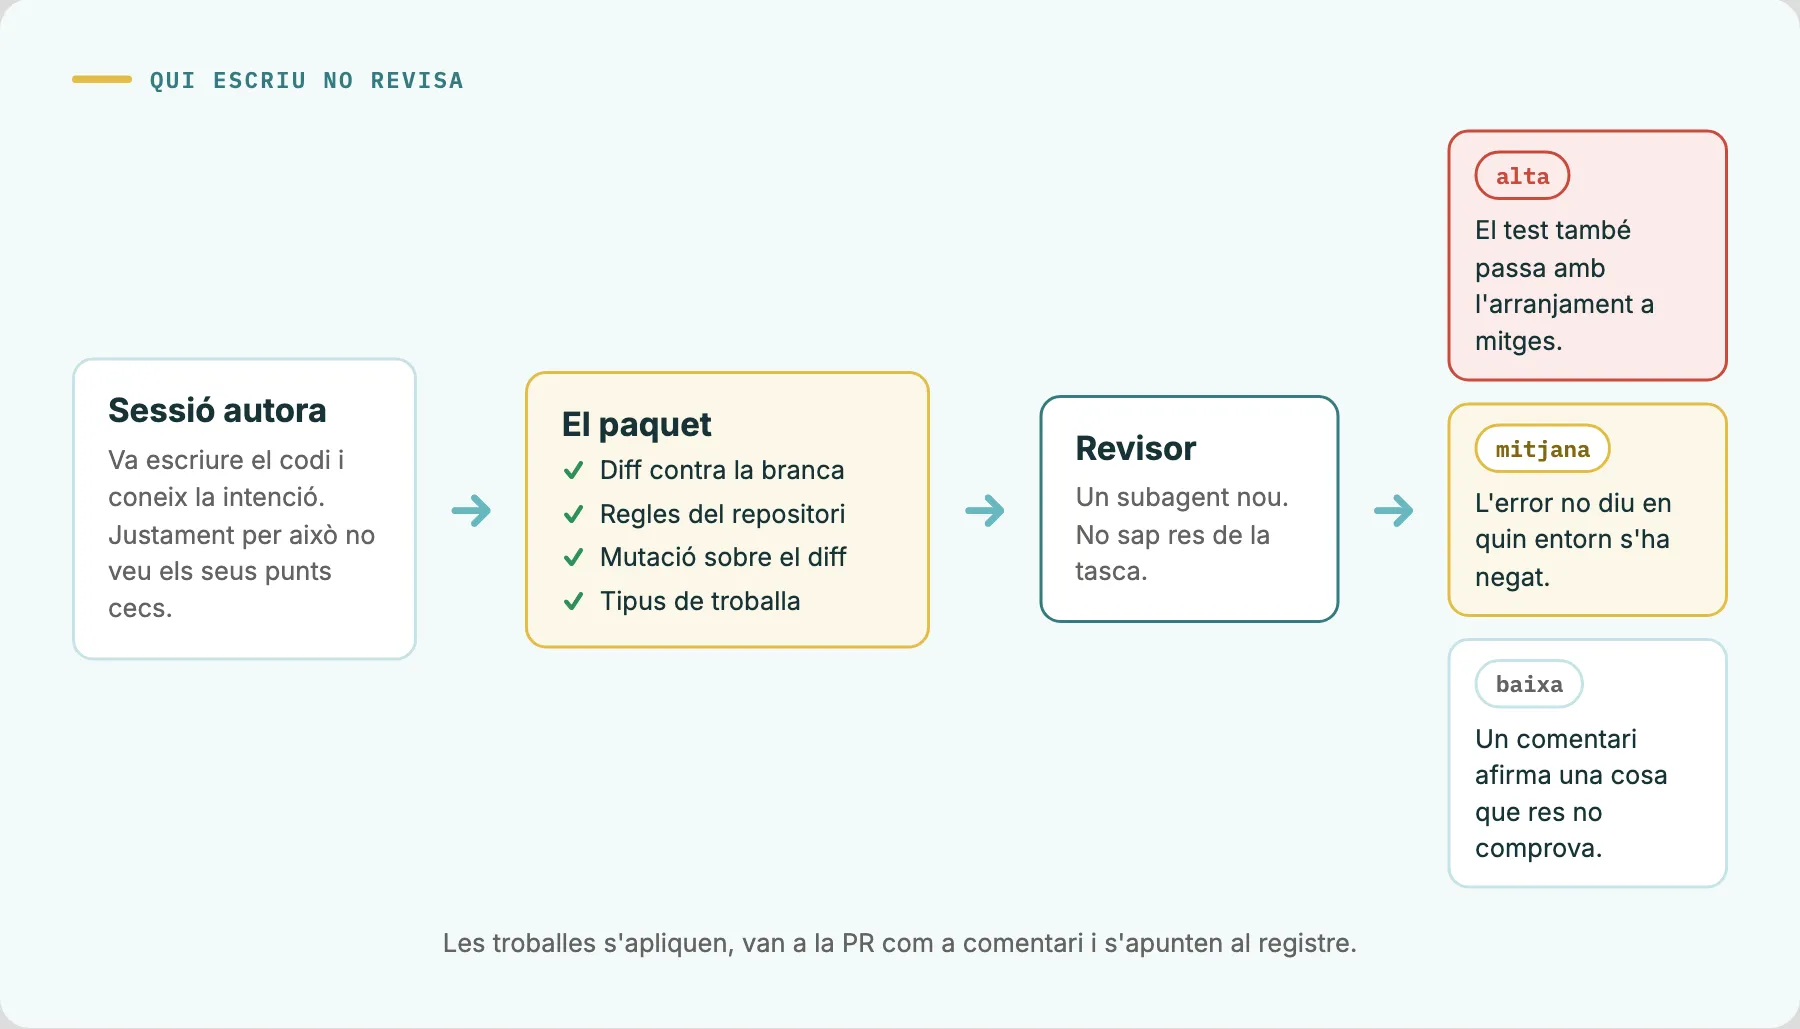
La revisió la fa un altre agent, sense el context de qui va escriure el codi. És un subagent que rep un paquet amb el diff, les regles del repositori i el resultat de les proves, i torna troballes amb la seva gravetat. Mai no ho revisa la mateixa sessió que ho va escriure, perquè qui escriu no veu els seus propis punts cecs. I CI no repeteix la revisió: el que no veu el revisor no ho veu ningú.
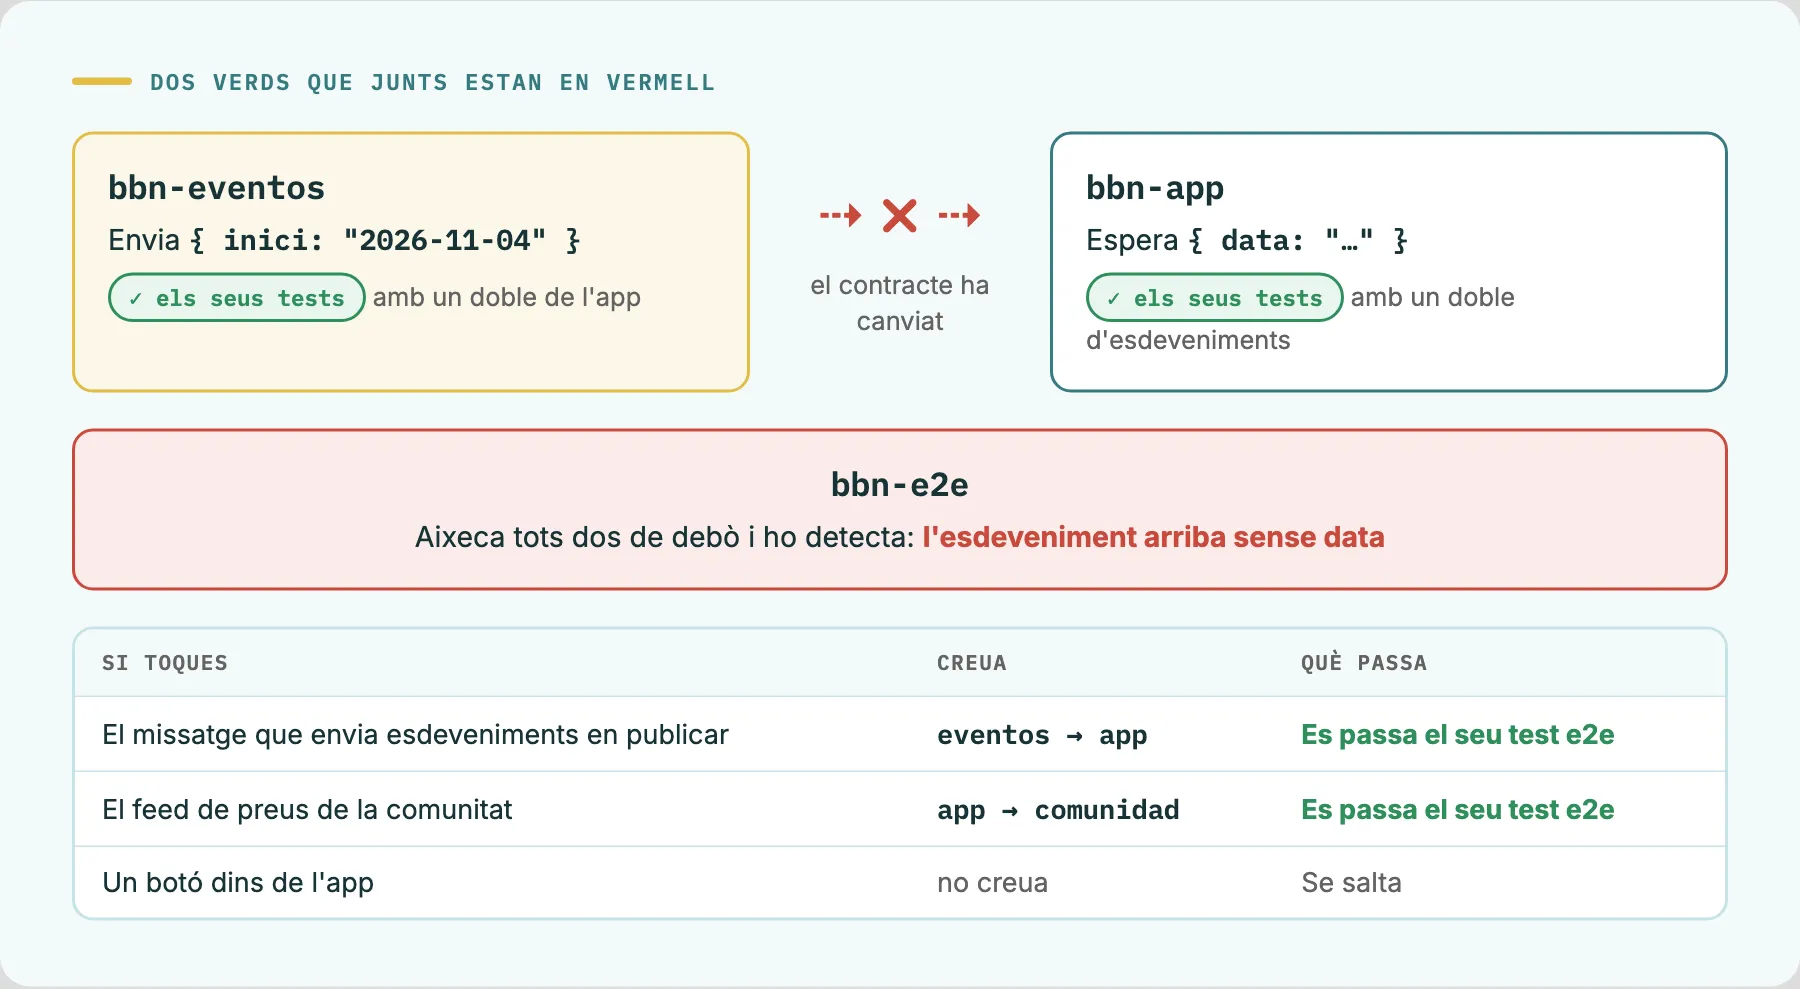
5. Proves entre repositoris, només quan calen. Cada repositori prova la seva part amb un doble de l’altre costat. Això vol dir que dos repositoris poden passar en verd amb el contracte entre ells trencat. Per això existeix un repositori de proves d’extrem a extrem amb una taula de costures: si toques el missatge que la plataforma d’esdeveniments envia a l’aplicació, es trenca aquest flux i es passa aquest test. Si el canvi cau en una costura, la tasca actualitza aquell test i el passa, o diu explícitament que no l’ha pogut passar. Si no cau en cap, se salta.
6. La PR. S’obre en esborrany, passa els tests repartits en quatre tandes en paral·lel i, quan està en verd, passa a llesta. En vermell no es fa merge, i «en local passava» no compta com a motiu.
7. El merge. Aquí hi ha la guarda més treballada de totes, i té el seu propi apartat més avall.
8. Producció. Fer merge és publicar: el merge a main desplega sol. La tasca es dona per tancada quan és a main, desplegada en verd, i un script ha recollit la còpia de treball, la seva base de dades i les seves branques.
Hooks: regles que es compleixen soles
Claude Code permet configurar hooks: scripts que s’executen en moments fixos (en arrencar una sessió, després de cada edició, abans de cada ordre de terminal) i que poden bloquejar el que està a punt de passar. Per a nosaltres són la diferència entre una regla escrita i una regla que es compleix.
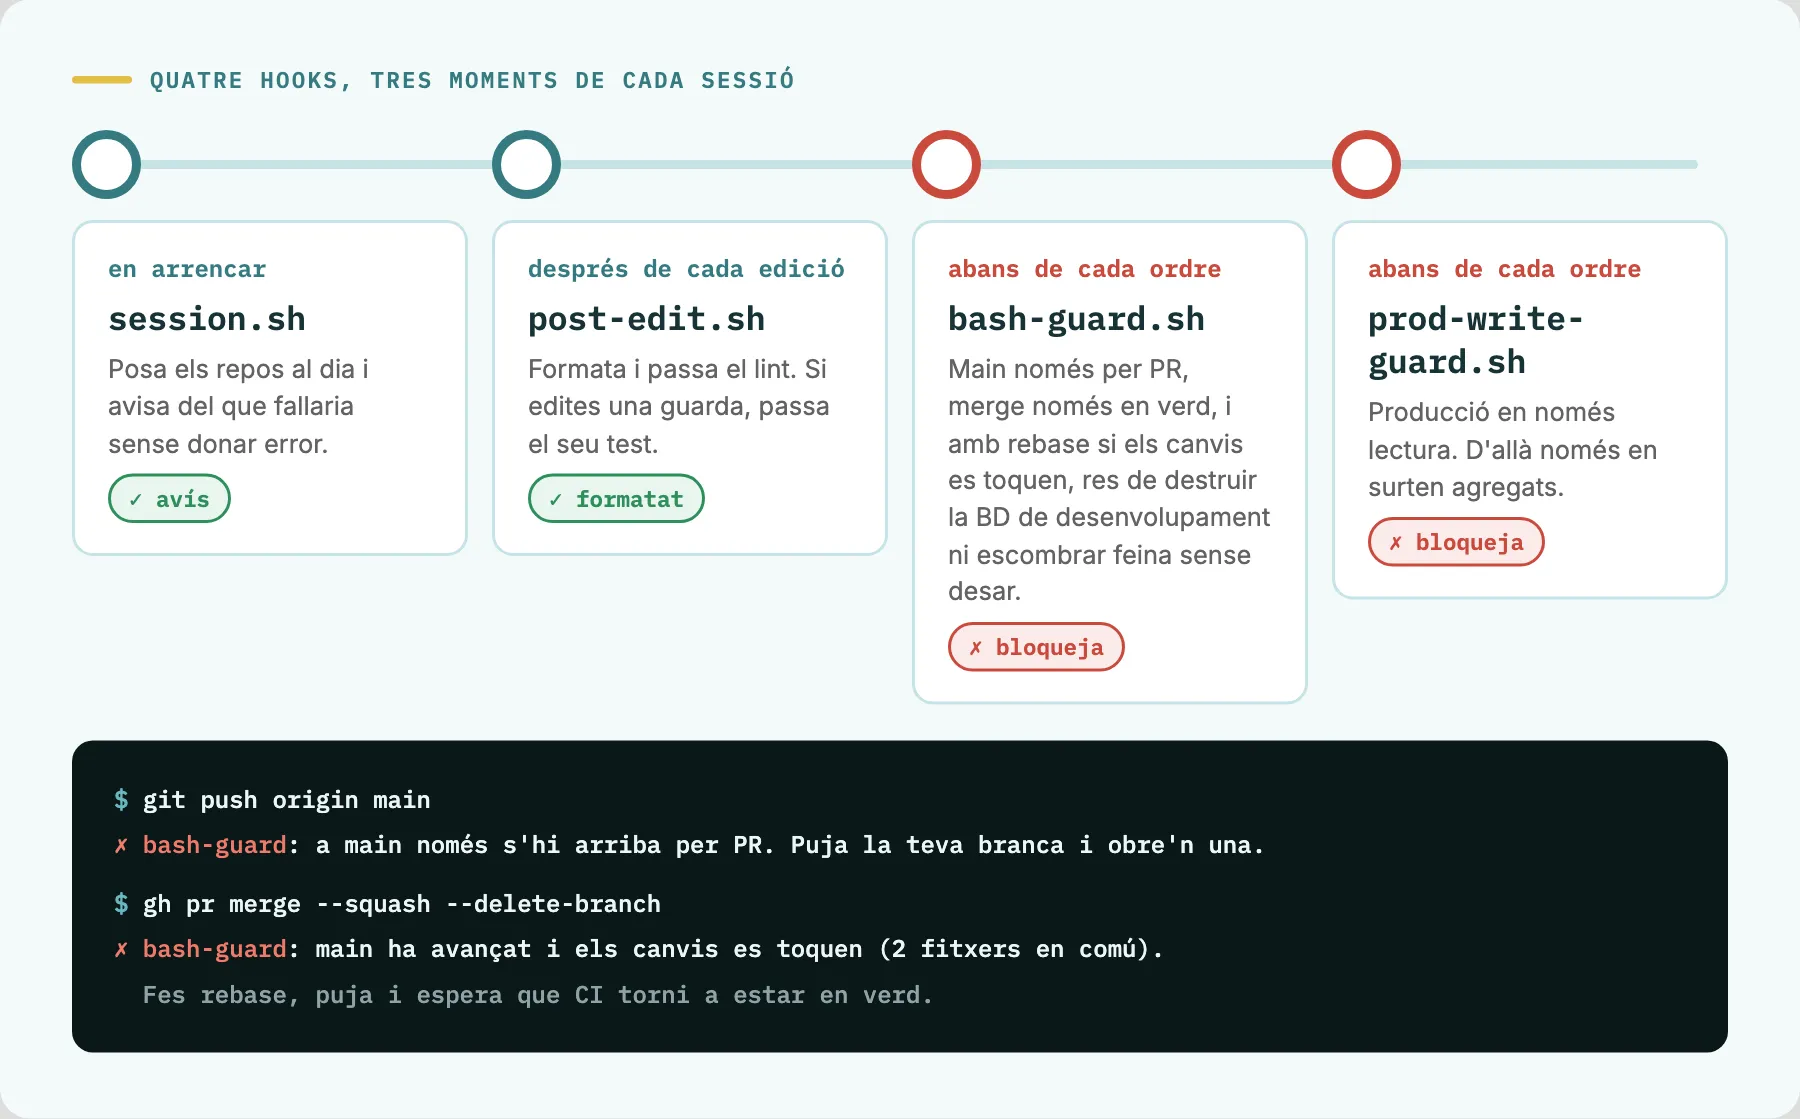
En tenim quatre:
- En arrencar, el que posa els repositoris al dia i avisa de les fallades silencioses.
- Després de cada edició, el que formata el codi i passa el lint. Si l’edició toca una de les guardes, passa a més el test de les guardes.
- Abans de cada ordre de terminal, una guarda que bloqueja el push directe a main als repositoris de producte, qualsevol manera de destruir la base de dades de desenvolupament fora d’una còpia de treball, i les ordres que escombrarien feina sense desar. Aquesta última només bloqueja si de debò hi ha alguna cosa a perdre.
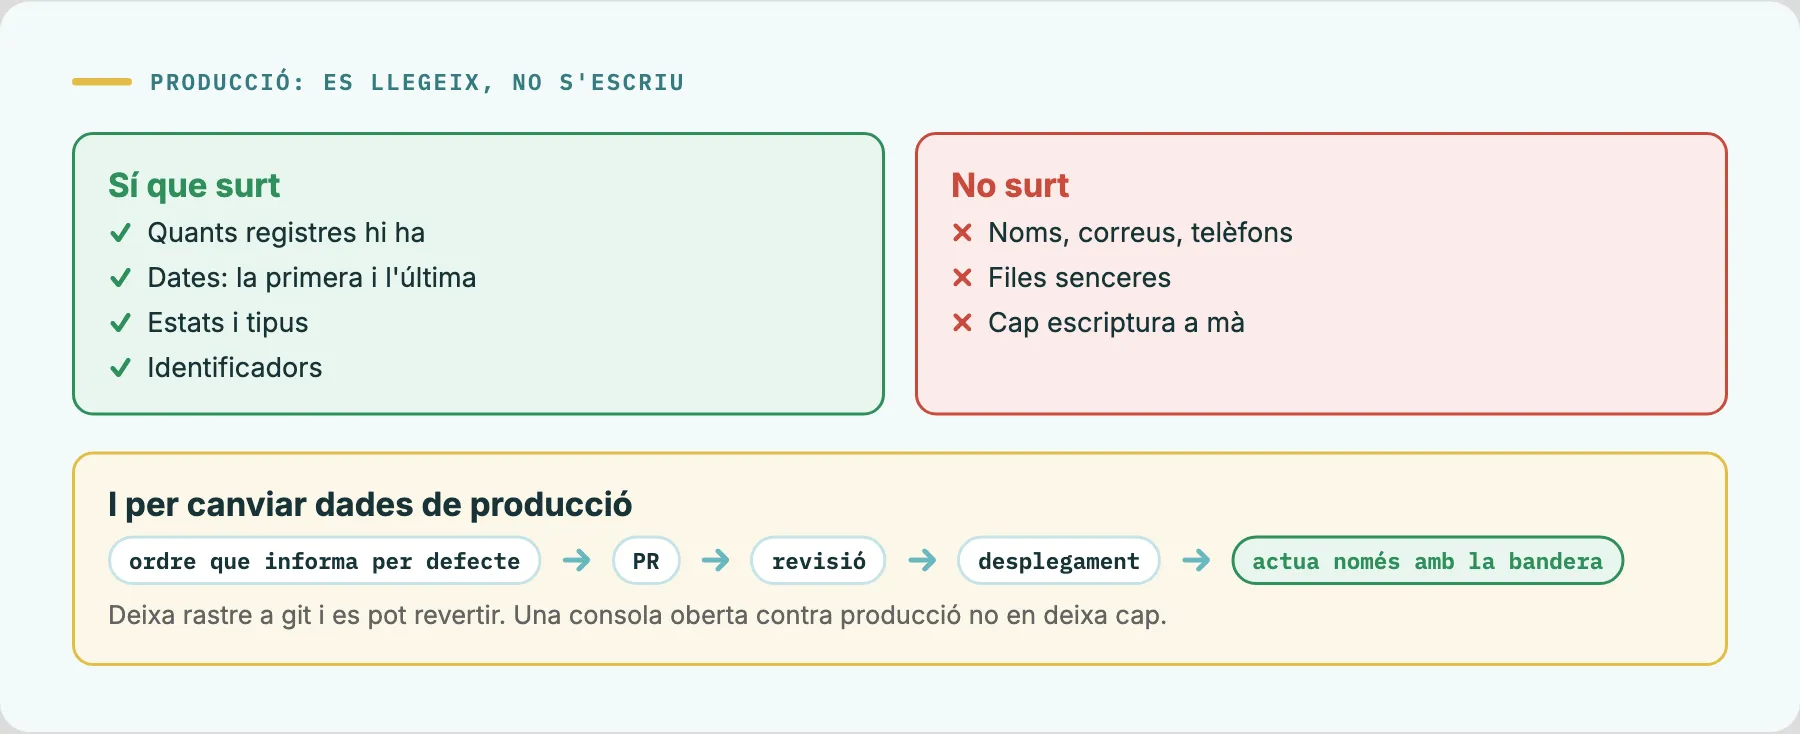
- Abans de cada ordre de terminal, una altra guarda que deixa producció en només lectura. D’allà només en surten agregats (quants, des de quan) i mai camps amb dades personals.
Canviar dades de producció es pot fer, però només d’una manera: amb una ordre que per defecte només informa del que faria i només actua amb una bandera explícita, arriba en una PR, es revisa i es desplega. Costa unes hores més, però deixa rastre a git i es pot revertir. Una consola oberta contra producció només existeix a l’historial d’una conversa.
Les guardes segueixen uns quants principis que hem après a força d’equivocar-nos:
Sempre llista blanca. Una guarda que enumera el que és perillós et protegeix de l’error d’ahir. Una que enumera el que està permès et protegeix també del de demà. Ho apliquem igual dins del codi, per exemple a la comprovació que decideix si una ordre pot esborrar dades:
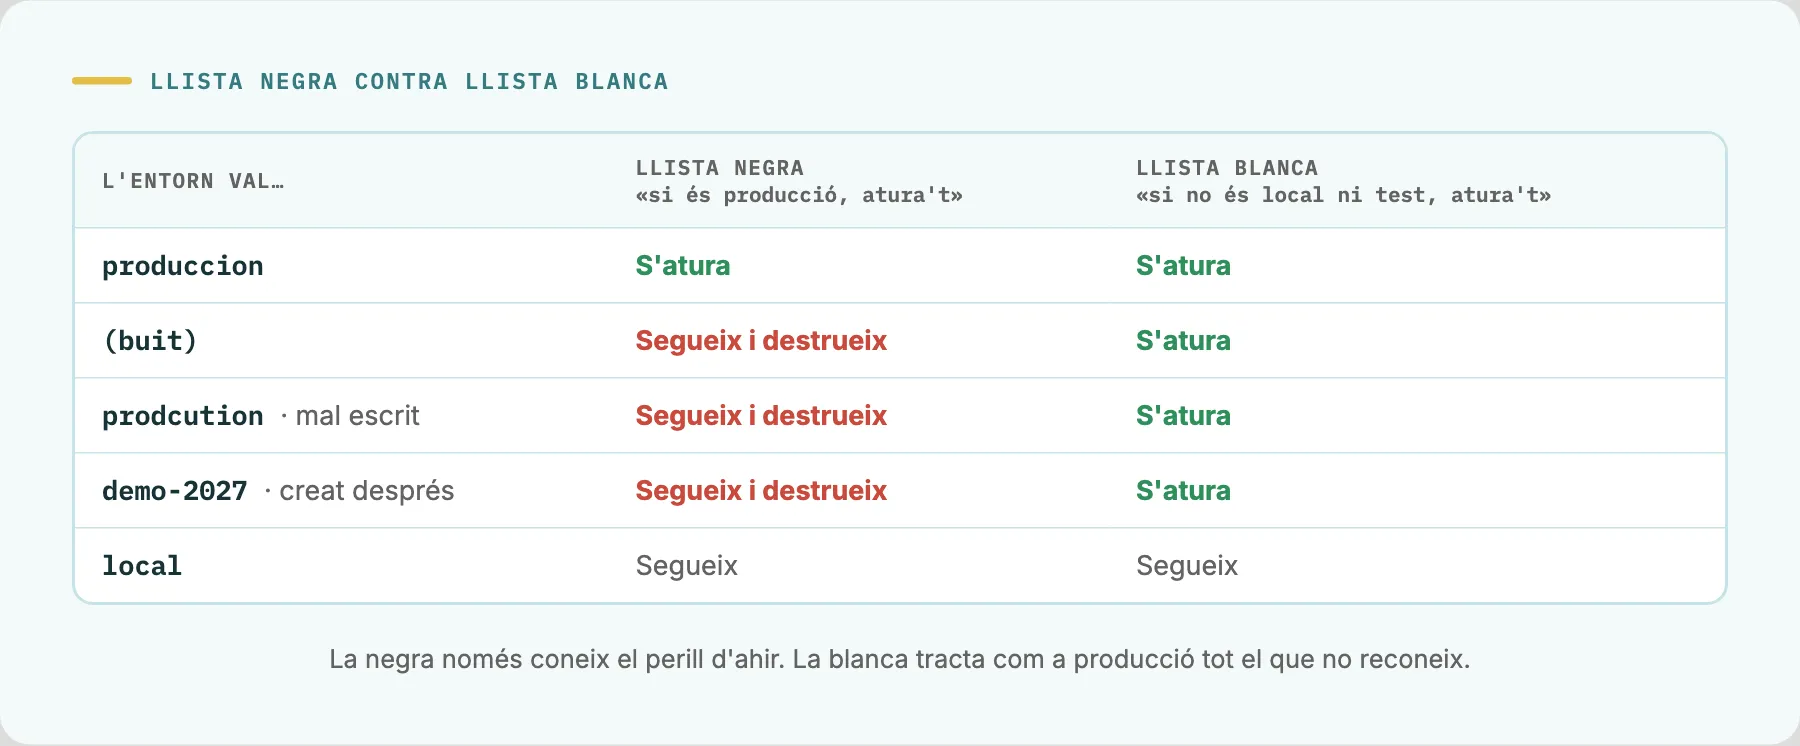
La llista negra deixa passar, i destrueix, si la variable d’entorn arriba buida, mal escrita o amb el nom d’un entorn creat després. La blanca tracta com a producció tot el que no reconeix.
Si no pot comprovar, bloqueja. Si a una guarda li falta una eina, no té xarxa o la màquina va tan carregada que no arriba a comprovar a temps, no deixa passar. Bloqueja i diu per què.
Una guarda que molesta acaba desactivada. Un fals positiu costa més del que sembla: la tercera vegada que una guarda bloqueja alguna cosa inofensiva, algú busca la manera d’apagar-la. Per això el test de les guardes comença pels falsos positius.
Les guardes també tenen tests. Ara mateix són 326 casos, cadascun amb la seva entrada i el resultat que s’espera. A més, cada guarda té una mutació: una versió trencada a propòsit que el test ha de detectar. Si una mutació sobreviu, falta un cas.
Cada hook s’ha de guanyar el lloc. Només automatitzem una fallada quan compleix dues condicions: és silenciosa (no dona error, o l’error parla d’una altra cosa) i una màquina la pot detectar. Per això no hi ha un hook que passi la suite sencera a cada edició, ni un que verifiqui el tancament en acabar cada sessió. El primer costaria minuts a cada canvi. El segon tindria tants falsos positius que el desactivaríem en una setmana.
El verd caduca
La guarda del merge mereix el seu propi apartat, perquè resol el problema més propi de treballar amb diversos agents alhora.
Una PR en verd està en verd respecte al main que hi havia quan es van passar els seus tests. Si mentrestant una altra tasca fa merge per sota, aquell verd ja no val, i GitHub no torna a passar els tests pel seu compte. Amb diverses sessions en paral·lel, això passa cada dia.
Així que abans de cada merge la guarda decideix. Comprova que la PR està en verd i que el que s’integrarà és exactament el que es va provar. Després mira si main ha avançat. Si el que ha entrat i el que vols integrar toquen fitxers diferents, deixa passar. Si es toquen, o si qualsevol dels dos canvia alguna cosa que altera l’entorn dels tests (dependències, configuració, migracions de base de dades, rutes), bloqueja. Llavors toca rebase, tornar a passar CI i tornar-ho a provar.
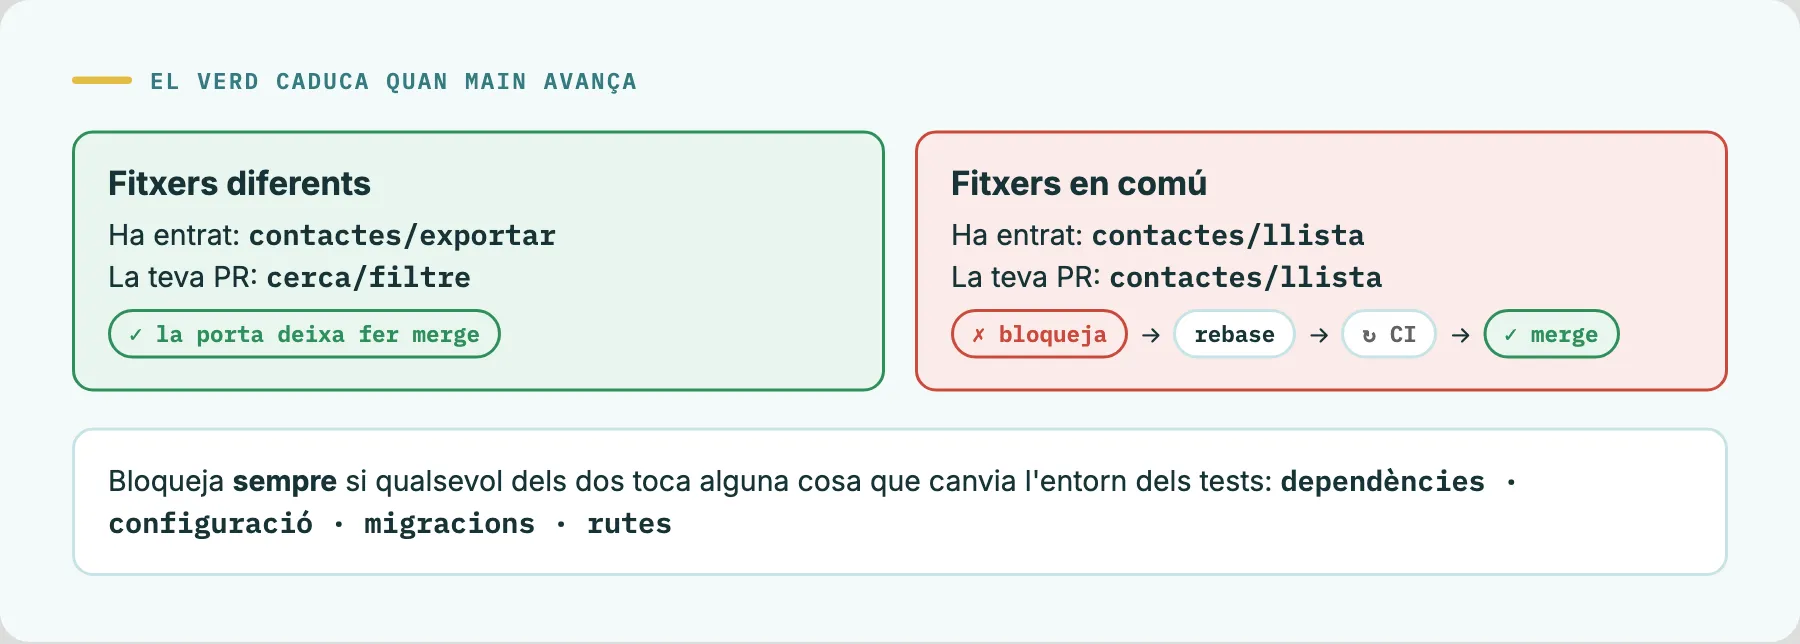
És el cas que es veu a l’animació: dues tasques al mateix repositori, la primera entra, i la segona es troba la porta tancada fins que es posa al dia.
Cada minut de CI compta
Els minuts de GitHub Actions es paguen, i amb diverses sessions empenyent alhora s’acaben molt de pressa. Ens vam arribar a quedar sense a mig mes. Des d’aleshores, cada peça de CI ha de justificar el que costa, igual que les guardes.
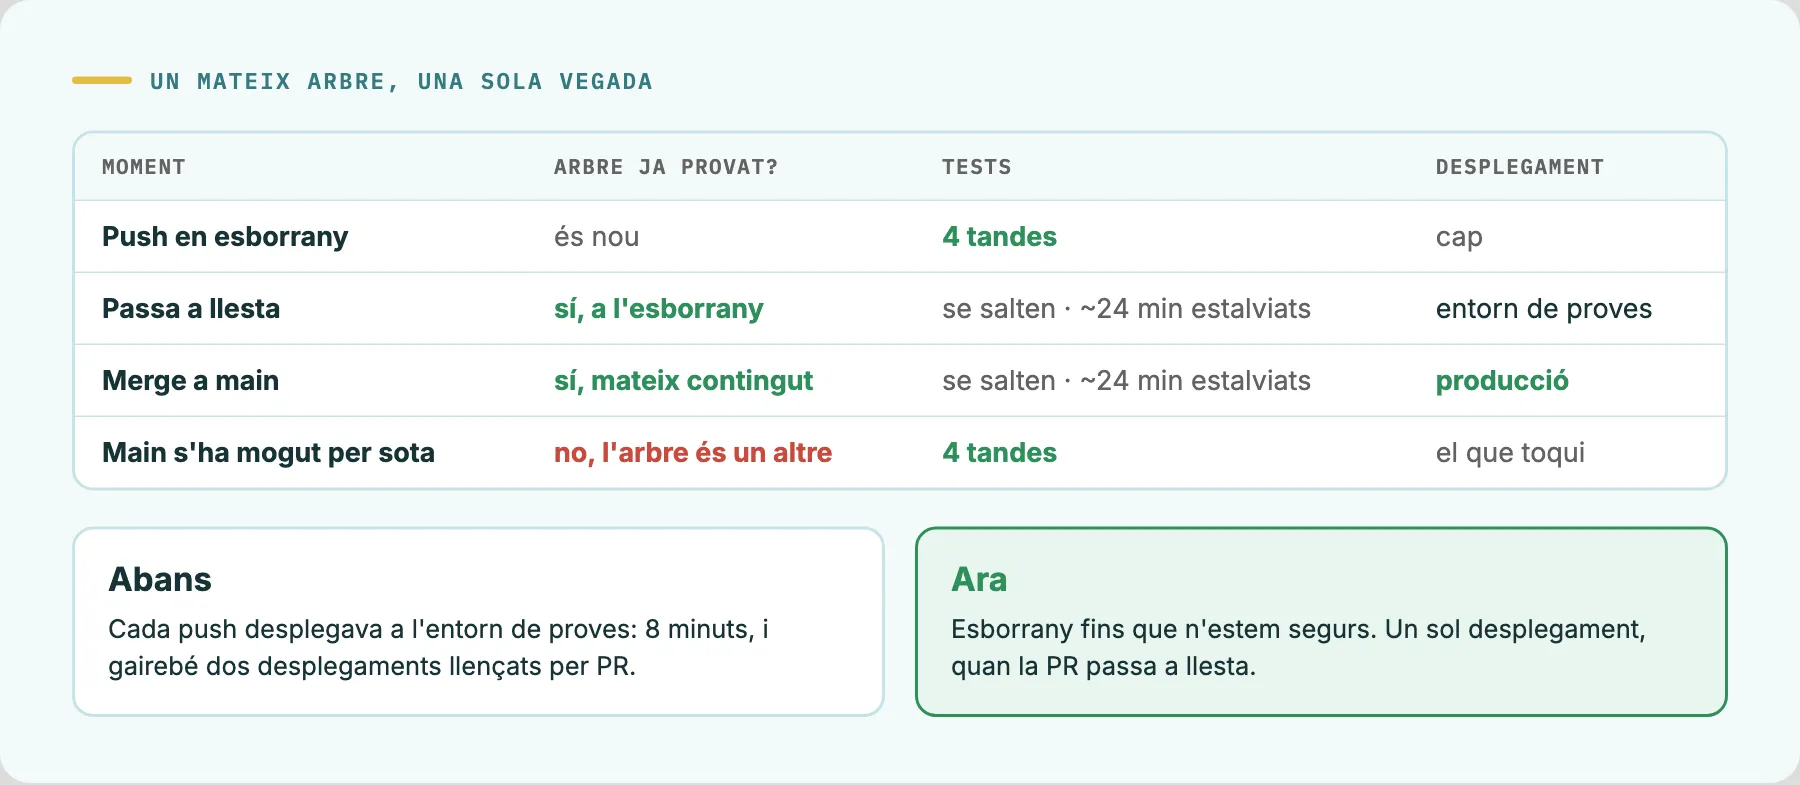
La PR neix en esborrany i no passa a llesta fins que n’estem segurs. En esborrany es passen els tests, però no es desplega res. Abans, cada push desplegava a l’entorn de proves: uns 8 minuts per desplegament, i gairebé dos desplegaments llençats per PR, perquè el push següent els deixava vells. Ara la PR passa a llesta només quan el tancament està fet i els tests de l’esborrany estan en verd. És llavors, i només llavors, quan desplega.
Un arbre que ja ha passat no es torna a provar. En passar a llesta, GitHub tornava a llançar la suite sencera sobre el mateix commit que l’esborrany acabava d’aprovar. I en fer merge, una altra vegada, sobre un commit nou amb exactament el mateix contingut. Ara el primer pas de CI mira el contingut exacte que ha de provar, sigui quina sigui la branca o el commit, i pregunta si ja ha passat tots els tests. Si la resposta és sí, la suite se salta, i són uns 24 minuts de runner cada vegada. Si main ha canviat per sota, l’arbre és un altre i els tests es passen, com ha de ser.
No fem servir la cua de merge de GitHub. Resoldria la cursa entre PRs que toquen el mateix, però torna a passar CI per a cada PR que entra a la cua. I l’alternativa habitual, exigir que la branca estigui al dia amb main, obliga a fer rebase i suite completa cada vegada que main es mou, encara que el que hagi entrat no hi tingui res a veure. La porta que hem explicat abans fa la mateixa feina demanant només el necessari: si els canvis no es toquen, el verd val; si es toquen, una altra volta.
Mutació, només sobre el que canvia. Les proves de mutació introdueixen petits errors a propòsit i comproven si els tests se n’adonen. A l’aplicació mutàvem els fitxers sencers que tocava cada canvi, gairebé deu minuts per tasca. Ara cada tasca muta només el que el seu canvi afegeix: treu cada condició nova, una a una, i comprova que algun test falla. Triga segons. També vam apagar la mesura setmanal de tot el codi: costava milers de minuts de CI al mes i gairebé mai arribava al final. A la plataforma d’esdeveniments, on mutar els fitxers tocats costa menys d’un minut, aquesta passada continua també dins del tancament.
I el que es pot trencar, millor trencar-ho en local. Cada push en vermell és un altre pipeline complet. El tancament obligatori existeix també per això: el que troba en local no gasta ni un minut de CI.
El bucle que aprèn
Tot l’anterior evita els errors que ja coneixem. Però els que més fan mal són els nous, i per a aquests hi ha un bucle amb dues entrades.
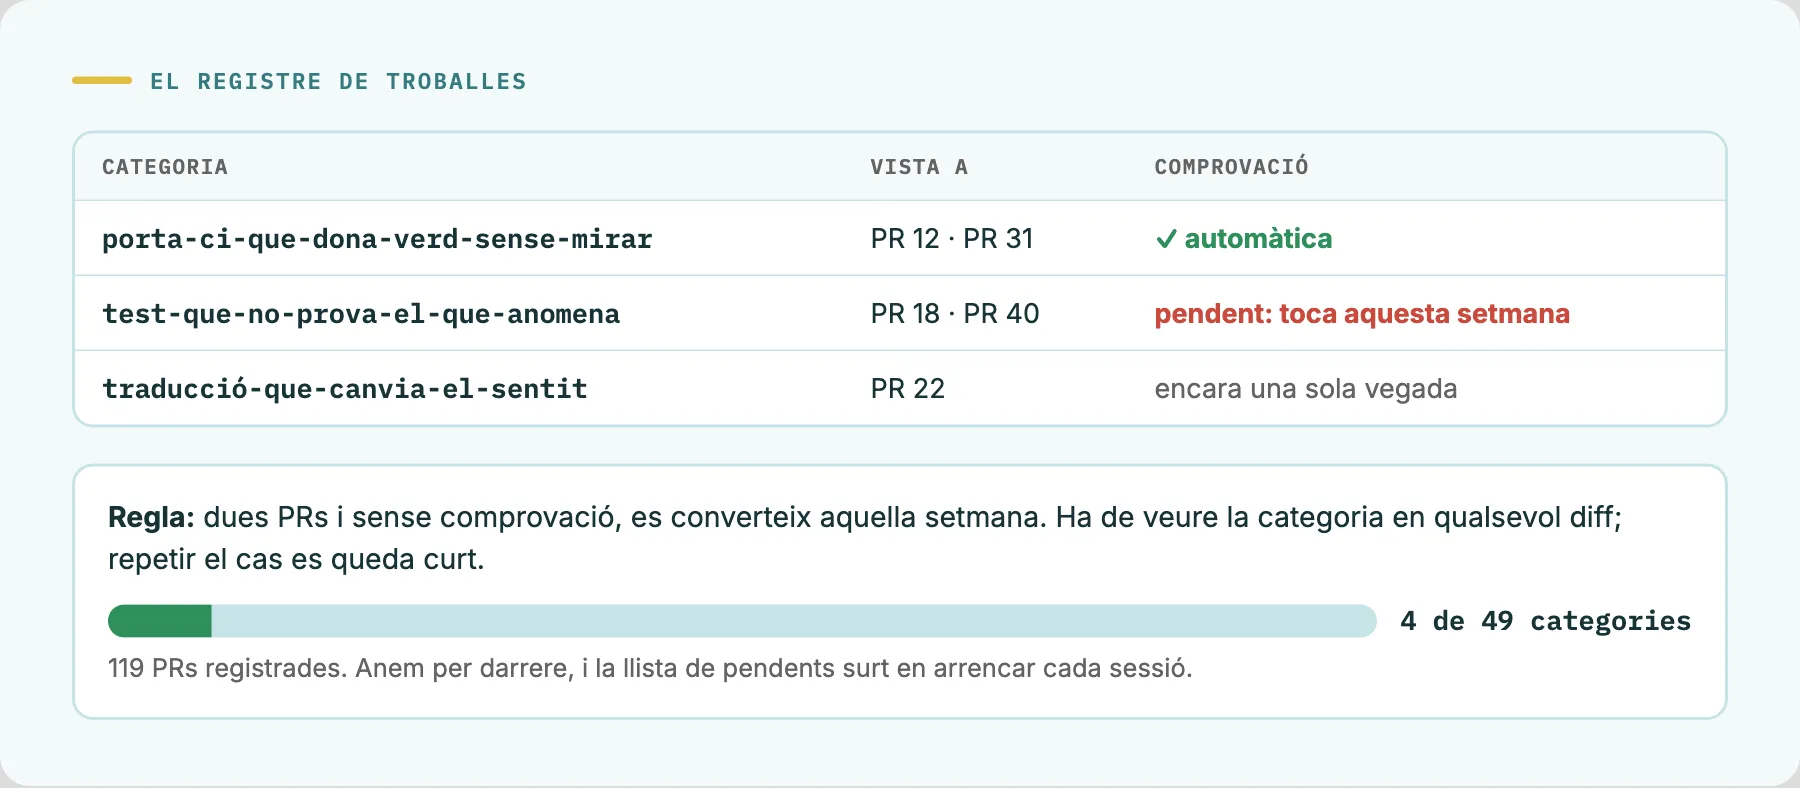
Les troballes de les revisions. Cada troballa del revisor de tancament s’apunta en un registre amb una categoria: «test que no prova el que diu», «fallada que surt en silenci», «traducció que canvia el sentit». La regla és que una categoria que apareix en dues PRs i encara no té comprovació automàtica s’hi converteix aquella mateixa setmana. Aquesta comprovació ha de detectar la categoria en qualsevol diff; repetir el test del cas que la va destapar es queda curt.
Hem de ser sincers amb els números. Portem 119 PRs registrades, 49 categories diferents, i només 4 s’han convertit ja en comprovació automàtica. Escriure una comprovació que vegi una categoria sencera sense donar falsos positius és difícil, i una mala comprovació és pitjor que cap. El que sí que està automatitzat és el recordatori: cada sessió arrenca amb la llista de categories pendents al davant.
Els incidents. Amb tot això, les coses es continuen trencant. Gairebé sempre per algun d’aquests motius:
- El que no dona error. Una configuració que apunta a l’entorn equivocat, un test que passa sense provar res o una dada que es calcula sobre una font que ja no existeix. Tot en verd, i tot malament.
- Dos canvis correctes que junts no ho són. Cada PR passa els seus tests per separat i el problema només apareix quan conviuen a main.
- El que només passa en un entorn. Les proves locals i CI fan servir bases de dades diferents, i el que una tolera, l’altra ho rebutja. O una variable que ningú no va fixar i que a la teva màquina val una altra cosa.
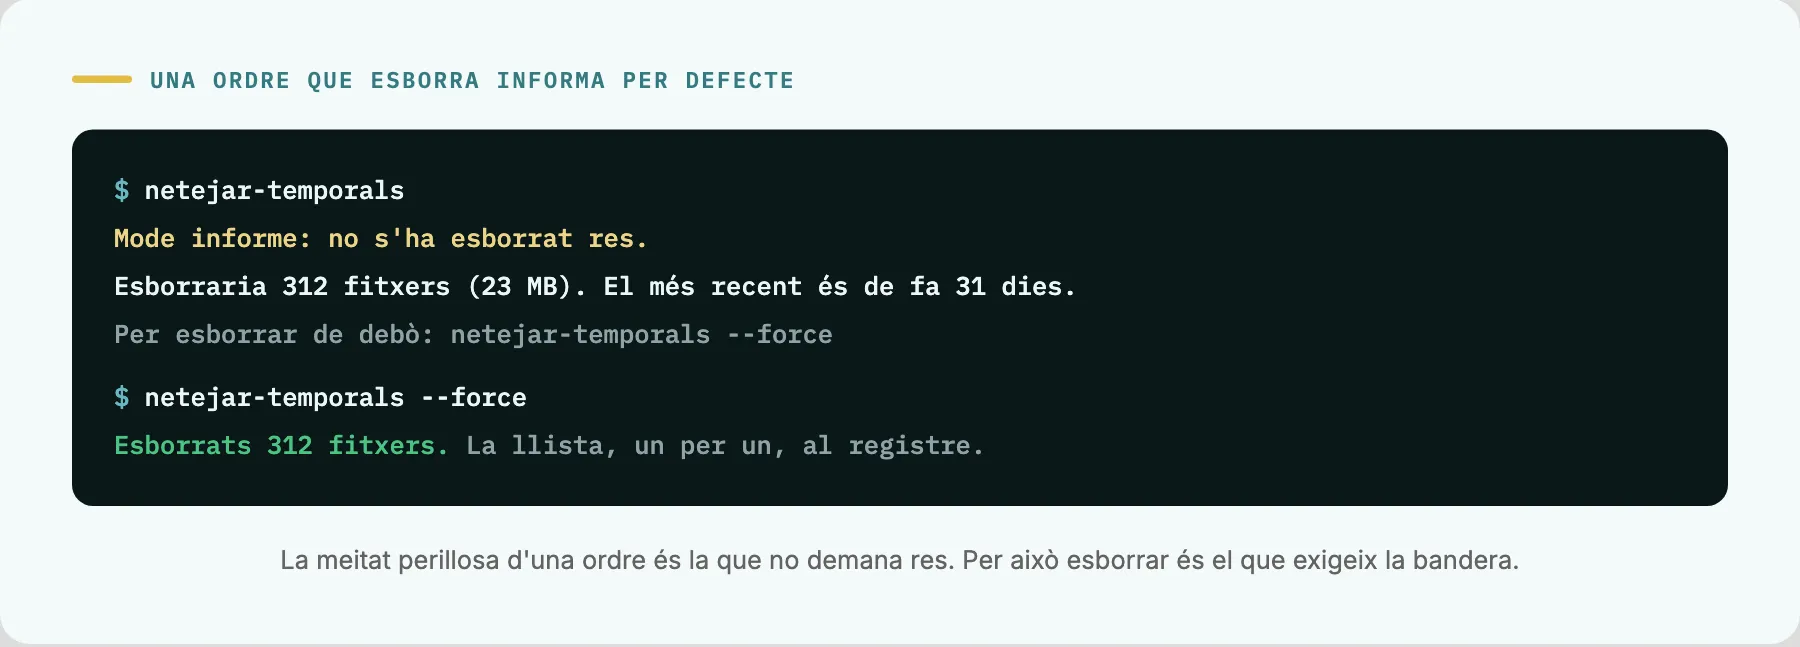
- Les ordres la meitat perillosa de les quals és la que no demana res. Una ordre que esborra quan l’executes sense arguments és una trampa esperant algú amb pressa. Per això tota ordre que esborra, trunca o sobreescriu dades informa per defecte i només actua amb una bandera explícita.
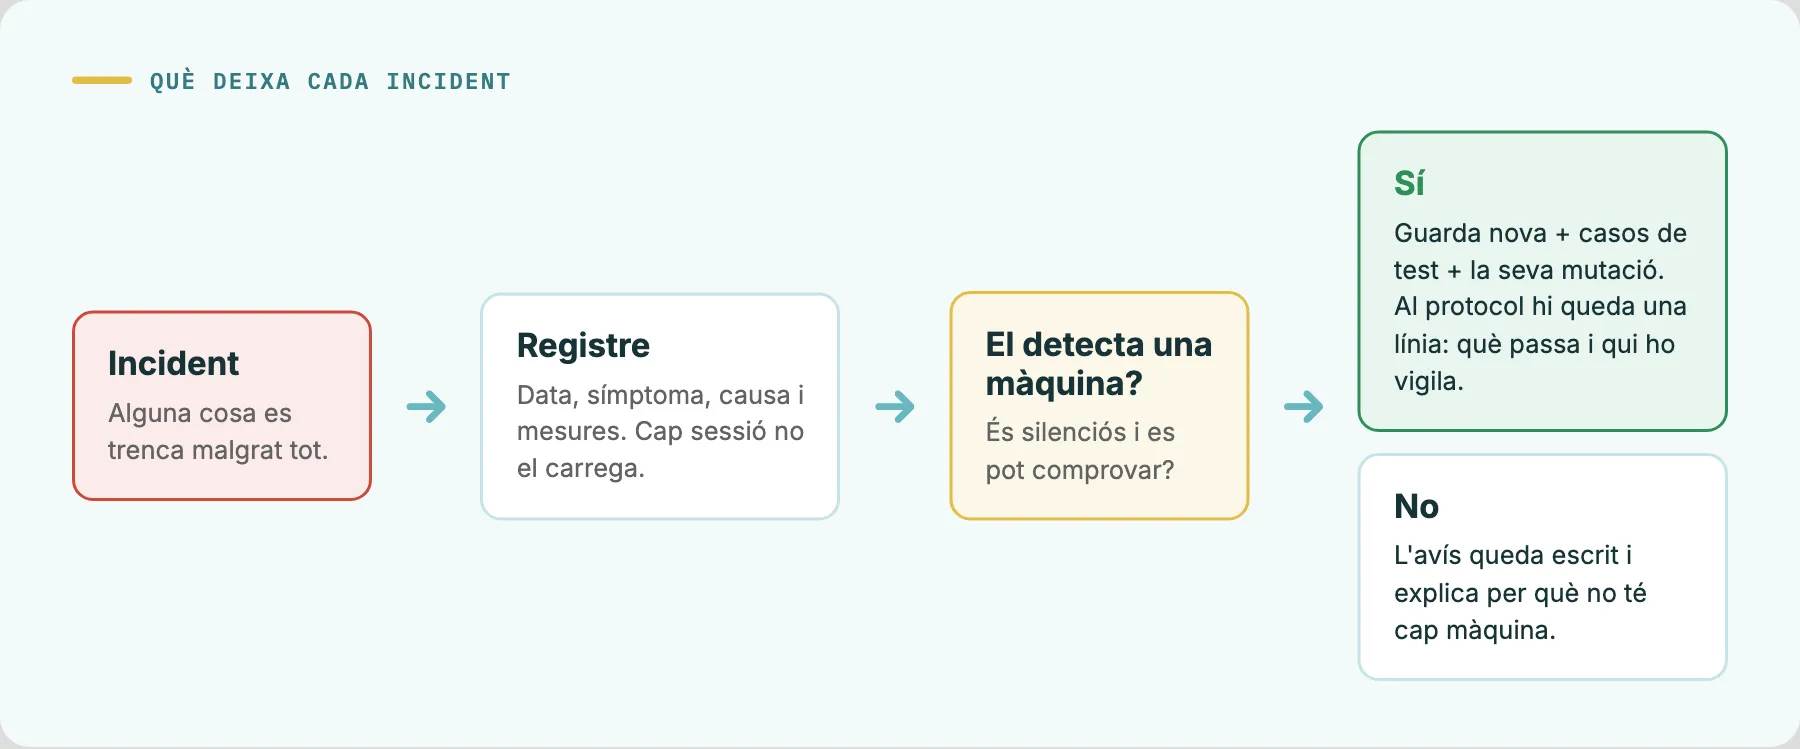
Cada incident s’apunta amb la seva data, el seu símptoma, la seva causa i les mesures preses. Si una màquina el pot detectar, es converteix en una guarda amb els seus casos de test i la seva mutació, i al protocol hi queda una sola línia. Si no pot, l’avís queda escrit i explica per què no té cap màquina al darrere.
És això una software factory?
Ara tothom parla de software factories: agents que reben una idea per un costat i lliuren software acabat per l’altre. La pregunta és inevitable, i la resposta curta és que només en part.
Hi ha coses que sí que són de fàbrica. Hi ha una línia amb estacions fixes, i cada repositori té la seva. Les guardes fan el que en una planta fan els sistemes a prova d’errors: fan que la fallada no pugui passar. La línia s’atura sola quan alguna cosa va malament, amb un CI en vermell o un merge que xoca amb un altre. I hi ha millora contínua, perquè cada error que es repeteix ha d’acabar convertit en una comprovació.
Però n’hi ha d’altres que no. Què es construeix, quan comença una tasca i si està ben plantejada ho continuem decidint nosaltres. No hi ha una cua que es processi sola des del backlog fins a producció. I la millora contínua va per darrere, com expliquen aquests 4 de 49.
Per això preferim un altre nom per al que hem construït: el control de qualitat d’una fàbrica de software. Els agents produeixen i la línia decideix què passa.
El que ens emportem
- El context és pressupost. Un protocol que ningú no llegeix no protegeix de res. És millor una línia amb una màquina al darrere que un paràgraf ben escrit.
- Qui escriu no revisa. Un revisor sense context troba el que l’autor ja no pot veure, tant si és una persona com un agent.
- Màquines abans que memòria. Tot el que es pot comprovar es comprova sol, i tot el que no, s’escriu amb el seu perquè.
- No tot mereix una màquina. Una comprovació que costa minuts a cada canvi, o que molesta més del que protegeix, acaba desactivada. Cada peça s’ha de pagar amb el temps que estalvia.
Treballar així ens dona tranquil·litat. La major part del que podria sortir malament s’atura abans d’arribar a producció, i el que hi arriba deixa alguna cosa apresa per a la propera vegada.
Si tu també treballes amb agents i vols comparar notes, escriu-nos. Ens encanta parlar d’això.
