Diez repositorios, varios agentes y ningún susto: así trabajamos con Claude Code

BlaBlaNote es un equipo pequeño con diez repositorios: la aplicación, la plataforma de eventos, el motor de matchmaking, la web, la comunidad, la extensión del navegador, la documentación, las pruebas de extremo a extremo, el cumplimiento legal y uno más que no despliega nada. Todo el código lo escribe Claude Code, muchas veces con varias sesiones a la vez y a veces con dos en el mismo repositorio. Y desplegamos a producción varias veces al día.
Con un equipo así, lo importante es conseguir que nada se rompa mientras se escribe tanto código.
Un agente no se cansa, pero empieza cada sesión sin acordarse de lo que pasó la semana anterior. Una persona sí se acuerda, durante unas semanas. Por eso la regla que lo ordena todo es sencilla de decir y bastante más difícil de cumplir: ninguna regla importante puede depender de que alguien se acuerde de ella.
Este artículo cuenta cómo lo hacemos. Son tres piezas: un repositorio que guarda las reglas, unos hooks que las hacen cumplir y un bucle que convierte cada error en una comprobación nueva.
El repositorio que no despliega nada
El décimo repositorio se llama planning. No tiene código de producto. Guarda el protocolo de trabajo que leen todas las sesiones, los planes de cada frente abierto, los hooks y los registros de incidentes y de hallazgos.
Vive aparte por un motivo práctico. Si el protocolo estuviera dentro de la aplicación, cada rama tendría su propia copia y cada copia iría por su lado. Separado, sobrevive a cualquier rama y a cualquier copia de trabajo, y todas las sesiones arrancan desde él con los repositorios de producto al lado.
Los planes llevan su estado al principio. Cada plan arranca con una línea Estado: y un índice los agrupa por frente y dice cuál manda en cada uno. Una sola orden saca el estado de todos, así que antes de dar algo por pendiente o por hecho se puede comprobar en segundos. Un plan nuevo sin su línea de estado o sin su entrada en el índice genera un aviso automático.
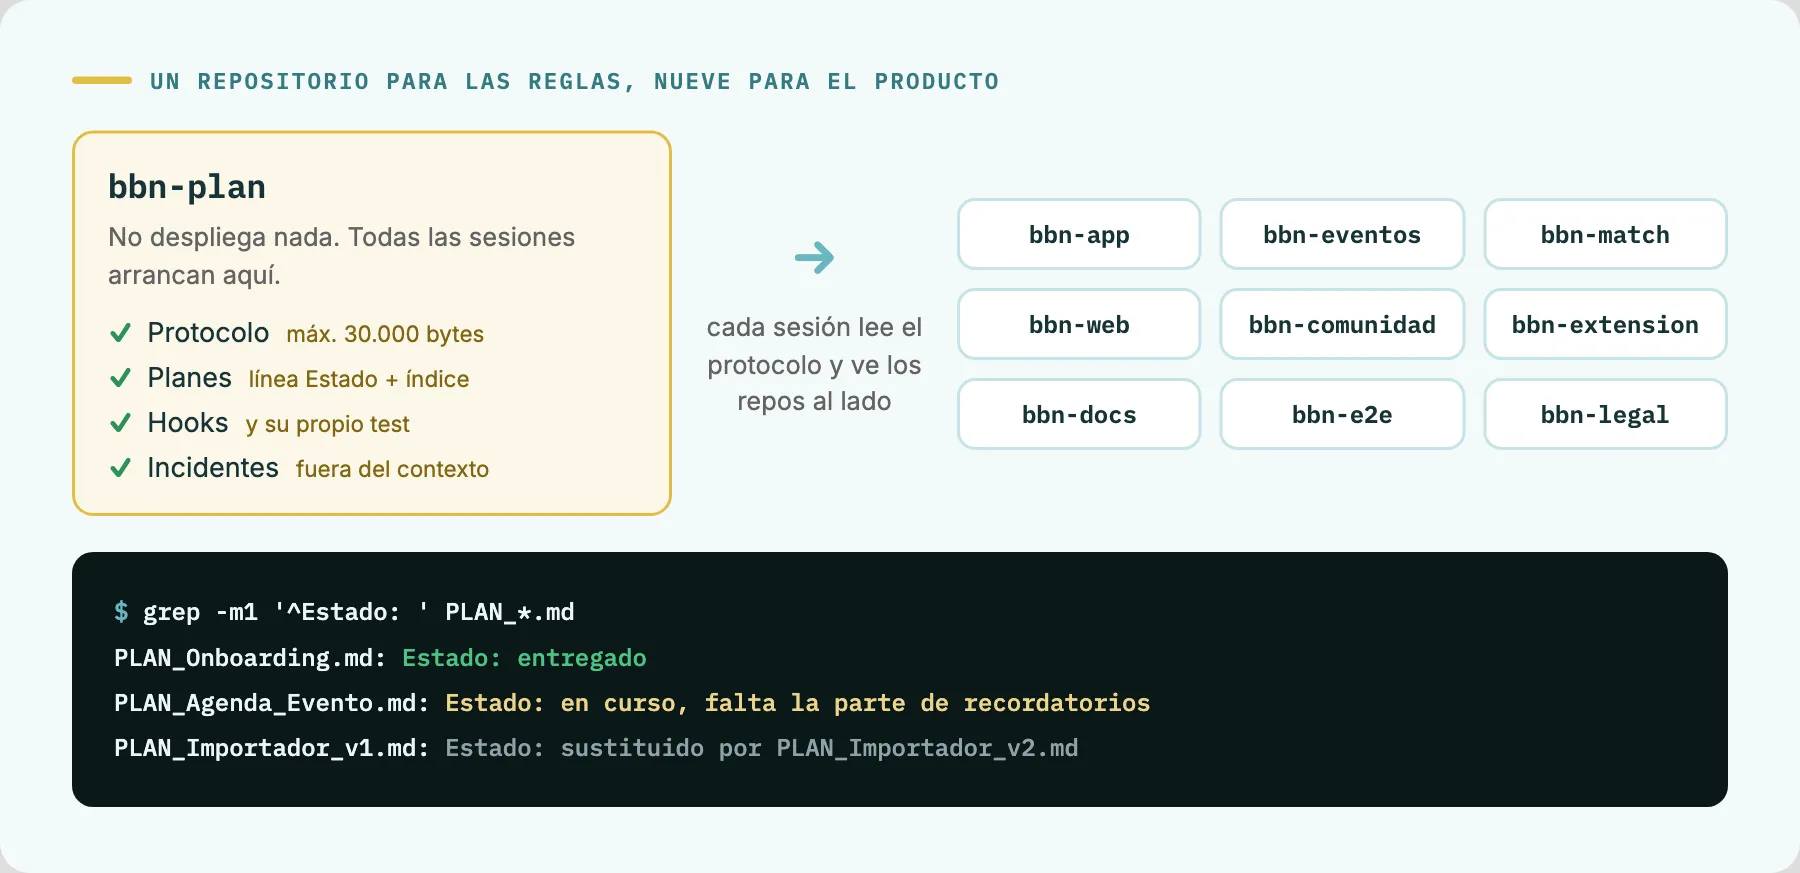
El protocolo tiene presupuesto. Tiene un tope de 30.000 bytes, y pasarse da un aviso. Esto parece un detalle y es lo más importante de todo el repositorio. Cada sesión de Claude Code carga el protocolo entero en su contexto, y un protocolo que crece sin límite acaba como cualquier manual largo: nadie lo lee de verdad. La regla de poda es esta: todo aviso que ya tiene una máquina detrás se reduce a una línea que dice qué pasa y quién lo vigila. La historia completa (fecha, síntoma, causa, medidas) se va a un fichero de incidentes que ninguna sesión carga.
Una tarea, de principio a fin
Así recorre una tarea el camino hasta producción.
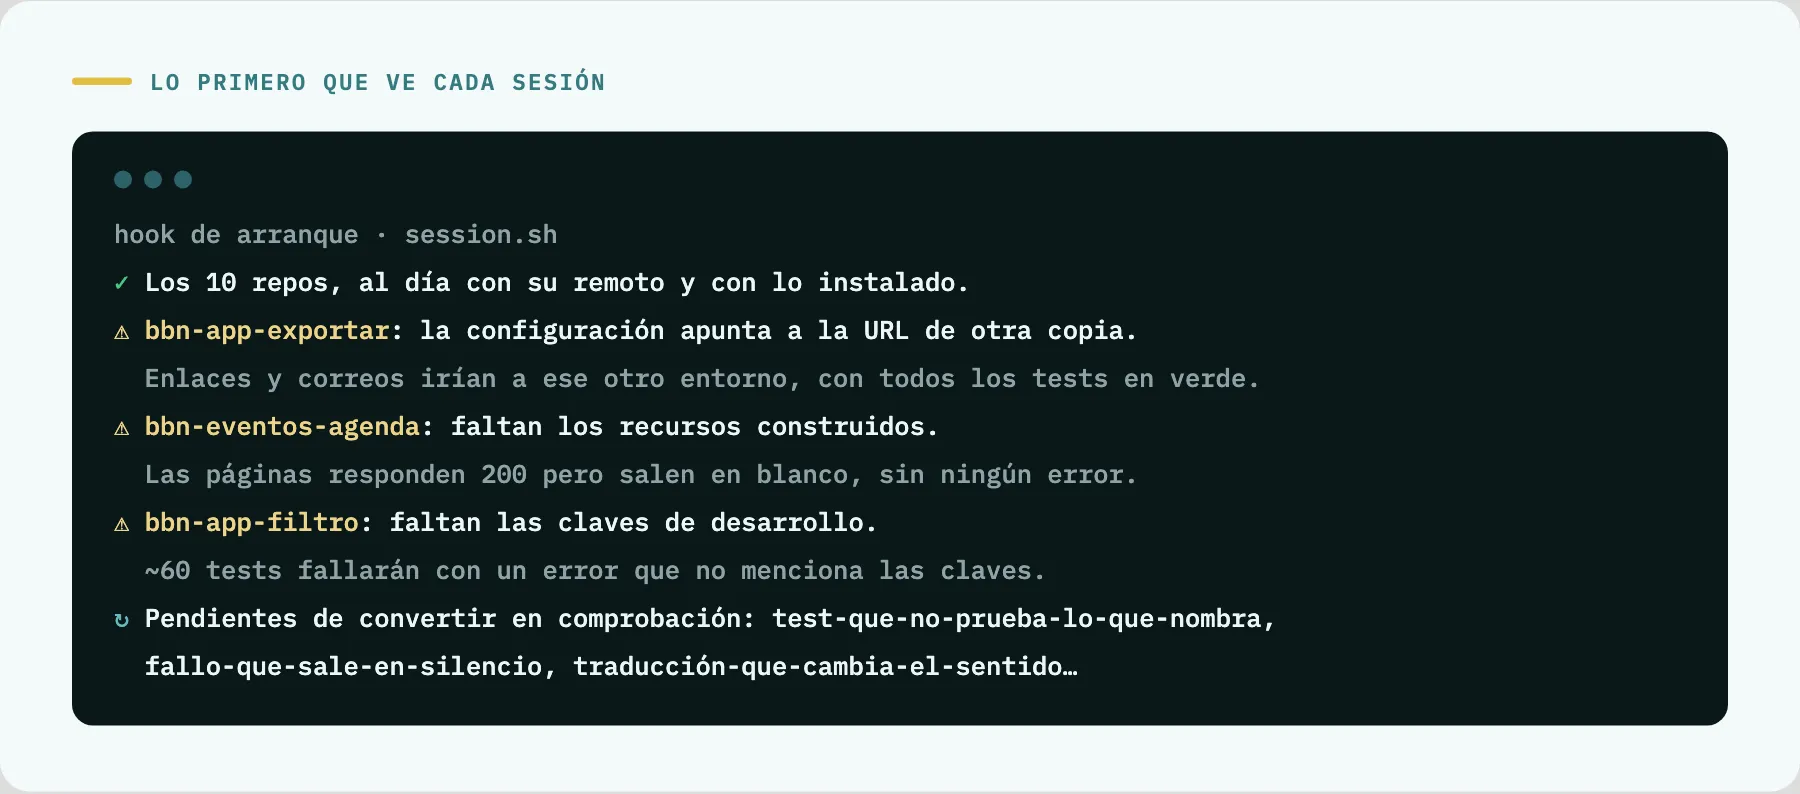
1. Arrancar con todo al día. Al empezar la sesión, un hook trae los cambios de los diez repositorios y compara cada uno con su remoto y con lo que tiene instalado. Leer código viejo no da ningún error: ni al leerlo ni al mirar su historial. Además, el hook revisa cada copia de trabajo y avisa de lo que fallaría sin decir nada, como una configuración que apunta al entorno de otra copia o unos recursos sin construir. Son fallos que acaban en tests verdes que no prueban nada, o en correos que salen hacia el sitio equivocado.
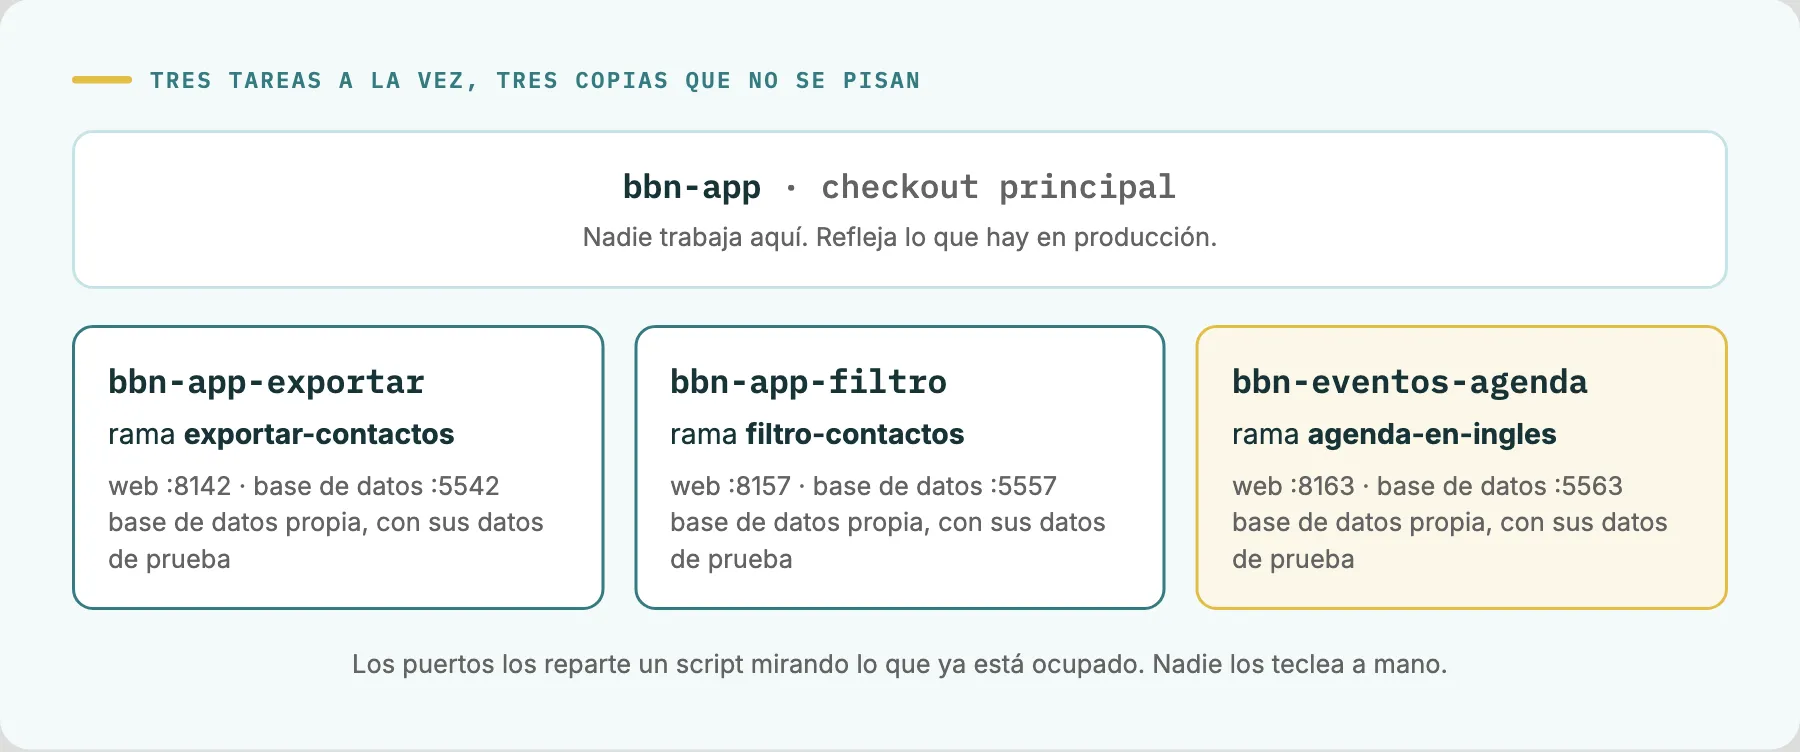
2. Cada tarea en su propia copia. Nunca se trabaja en el checkout principal, porque hay otras sesiones en paralelo. Cada tarea crea su copia de trabajo (un worktree de git) con su rama, sus puertos y su propia base de datos. Los puertos los reparte un script y nadie los teclea a mano. Dos sesiones sobre la misma base de datos se borrarían los datos de prueba la una a la otra, y lo harían en silencio.
3. Primero el test que falla. Tanto en el backend como en la interfaz. Un bug empieza siempre por un test que lo reproduce y falla antes de tocar nada. Después viene el código mínimo que lo pone en verde.
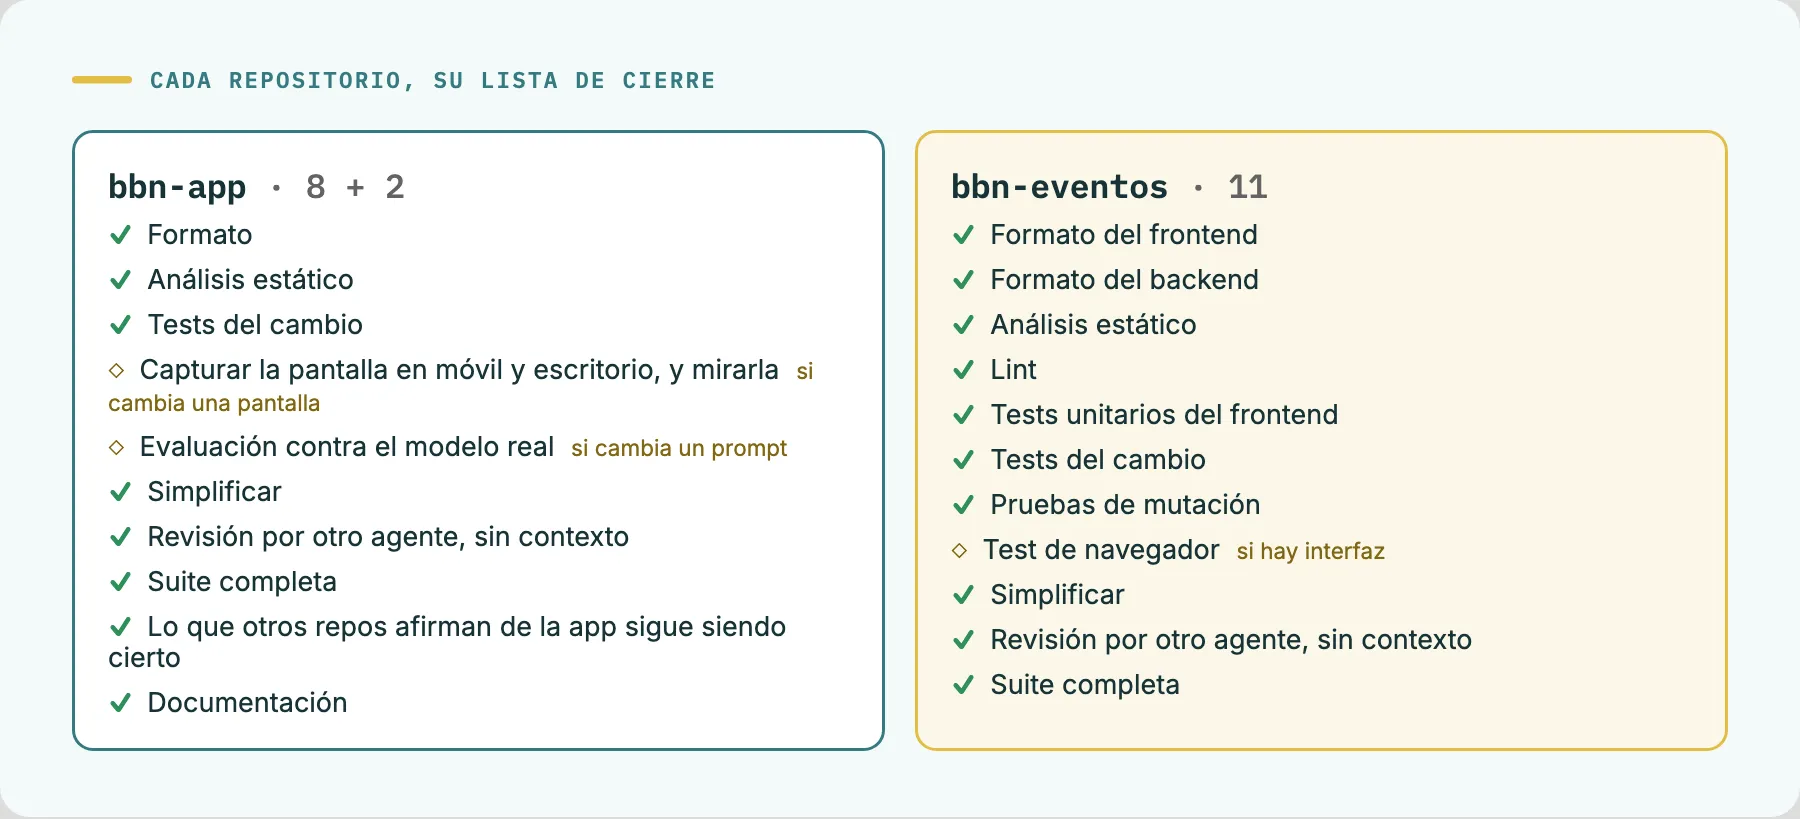
4. El cierre obligatorio de cada repositorio. Cada repositorio tiene su lista de cierre y no es opcional ni depende del tamaño del cambio. En la aplicación son ocho pasos fijos: formato, análisis estático, los tests del cambio, simplificar, revisión, la suite completa, comprobar que lo que otro repositorio afirma sobre la aplicación sigue siendo cierto y actualizar la documentación. Y dos más que dependen de lo que toque la tarea: si cambia una pantalla, se captura en móvil y en escritorio y se mira; si cambia un prompt, se corre su evaluación contra el modelo real. En la plataforma de eventos son once, entre ellos el lint del frontend, sus tests unitarios, pruebas de mutación y un test de navegador cuando el cambio tiene interfaz.
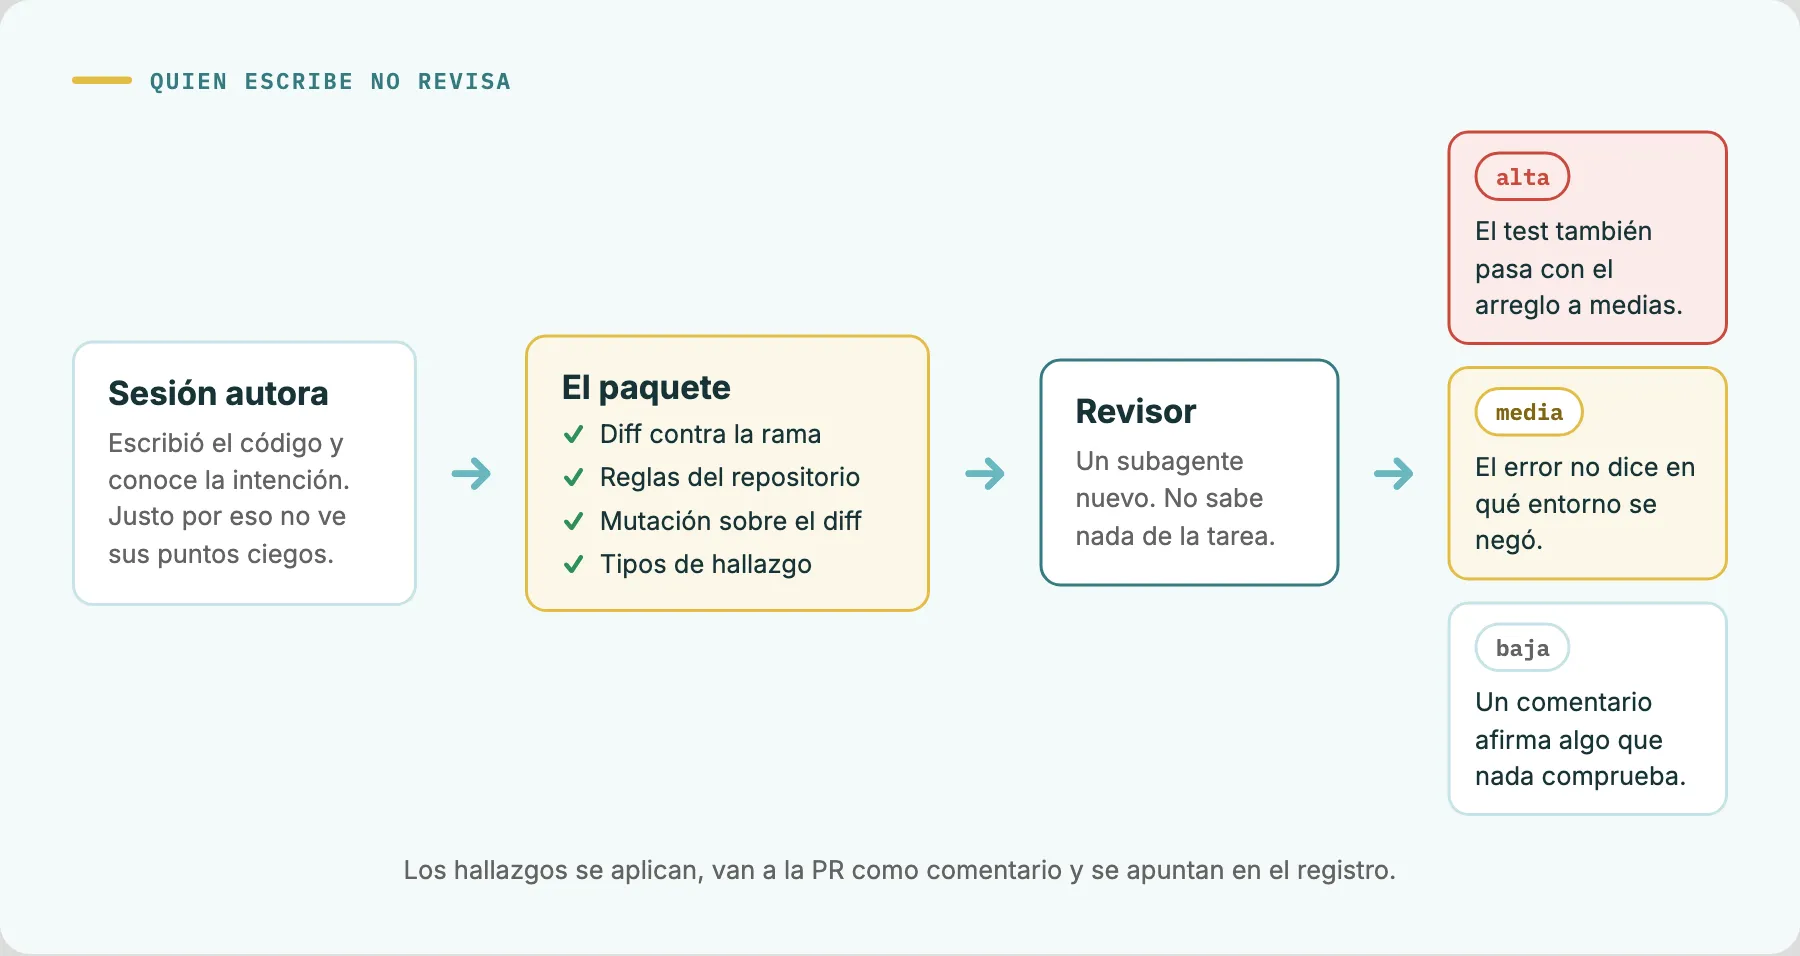
La revisión la hace otro agente, sin el contexto de quien escribió el código. Es un subagente que recibe un paquete con el diff, las reglas del repositorio y el resultado de las pruebas, y devuelve hallazgos con su gravedad. Nunca lo revisa la misma sesión que lo escribió, porque quien escribe no ve sus propios puntos ciegos. Y CI no repite la revisión: lo que no ve el revisor no lo ve nadie.
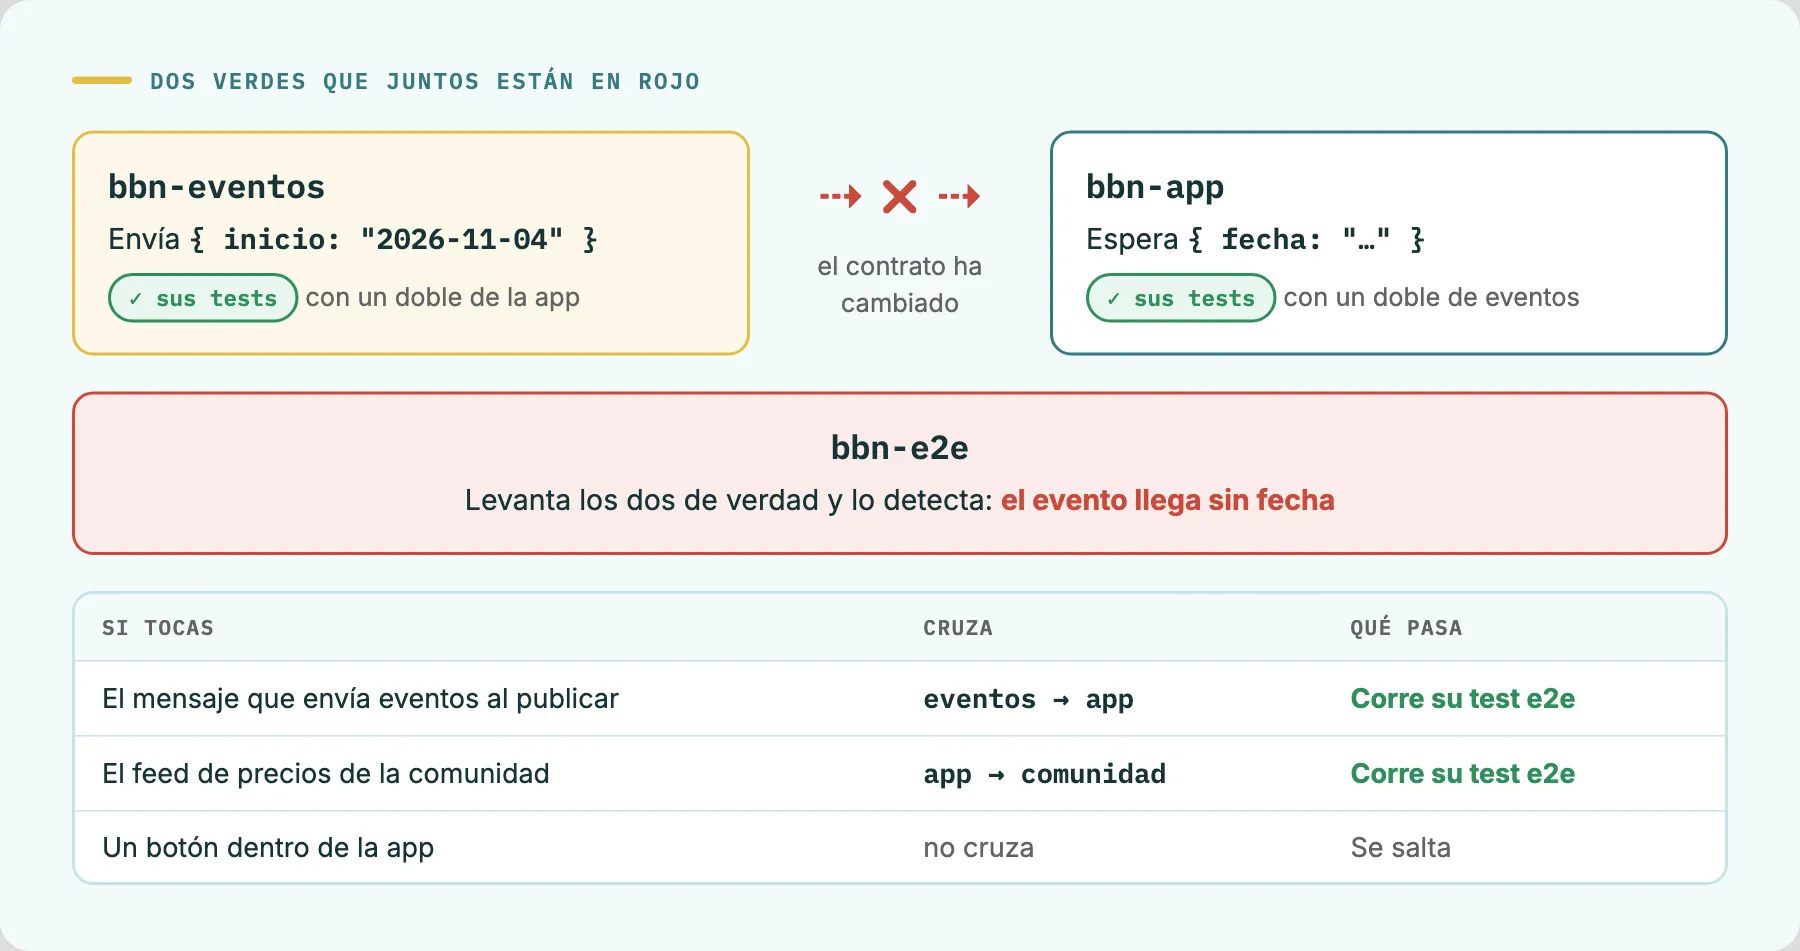
5. Pruebas entre repositorios, solo cuando hacen falta. Cada repositorio prueba su parte con un doble del otro lado. Eso significa que dos repositorios pueden pasar en verde con el contrato entre ellos roto. Para eso existe un repositorio de pruebas de extremo a extremo con una tabla de costuras: si tocas el mensaje que la plataforma de eventos envía a la aplicación, se rompe este flujo y se corre este test. Si el cambio cae en una costura, la tarea actualiza ese test y lo corre, o dice explícitamente que no ha podido correrlo. Si no cae en ninguna, se salta.
6. La PR. Se abre en borrador, corre los tests repartidos en cuatro tandas en paralelo y, cuando está en verde, pasa a lista. En rojo no se mergea, y «en local pasaba» no cuenta como motivo.
7. El merge. Aquí está la guarda más trabajada de todas, y tiene su propio apartado más abajo.
8. Producción. Mergear es publicar: el merge a main despliega solo. La tarea se da por cerrada cuando está en main, desplegada en verde, y un script ha recogido la copia de trabajo, su base de datos y sus ramas.
Hooks: reglas que se cumplen solas
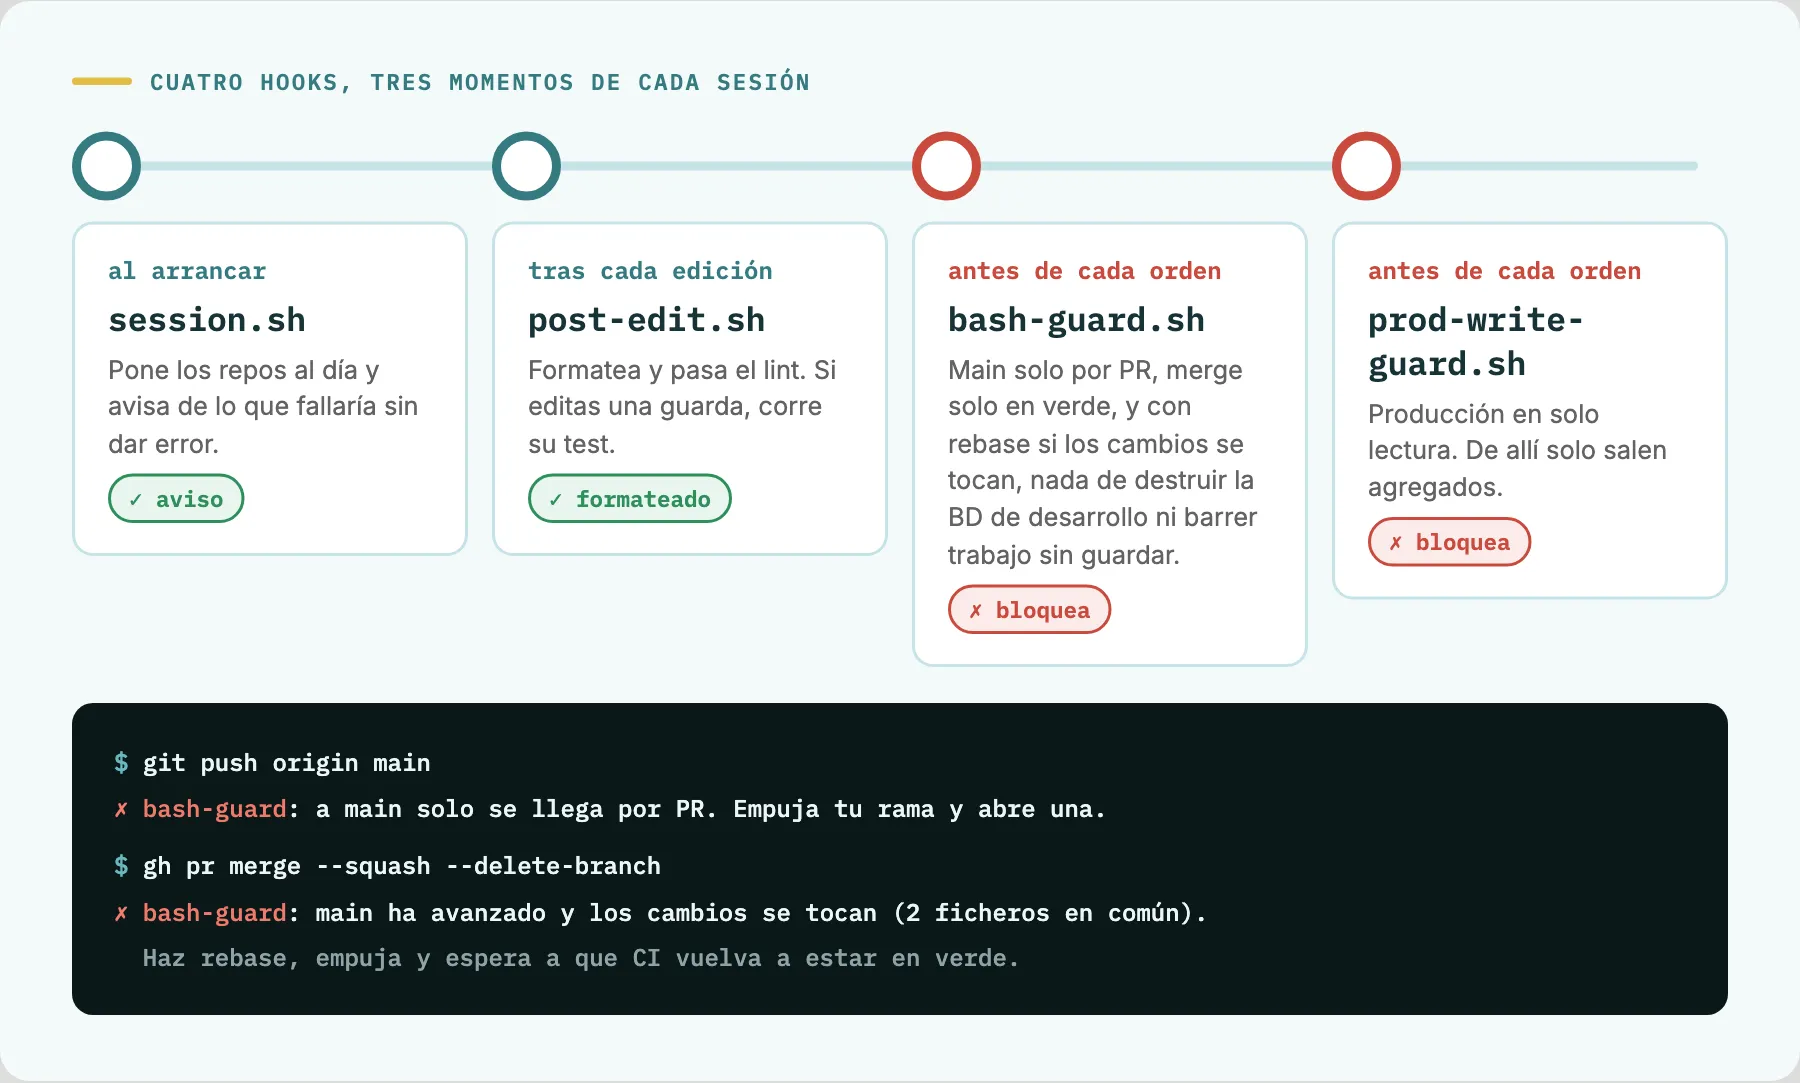
Claude Code permite configurar hooks: scripts que se ejecutan en momentos fijos (al arrancar una sesión, después de cada edición, antes de cada orden de terminal) y que pueden bloquear lo que va a pasar. Para nosotros son la diferencia entre una regla escrita y una regla que se cumple.
Tenemos cuatro:
- Al arrancar, el que pone los repositorios al día y avisa de los fallos silenciosos.
- Después de cada edición, el que formatea el código y pasa el lint. Si la edición toca una de las guardas, corre además el test de las guardas.
- Antes de cada orden de terminal, una guarda que bloquea el push directo a main en los repositorios de producto, cualquier forma de destruir la base de datos de desarrollo fuera de una copia de trabajo, y las órdenes que barrerían trabajo sin guardar. Esta última solo bloquea si de verdad hay algo que perder.
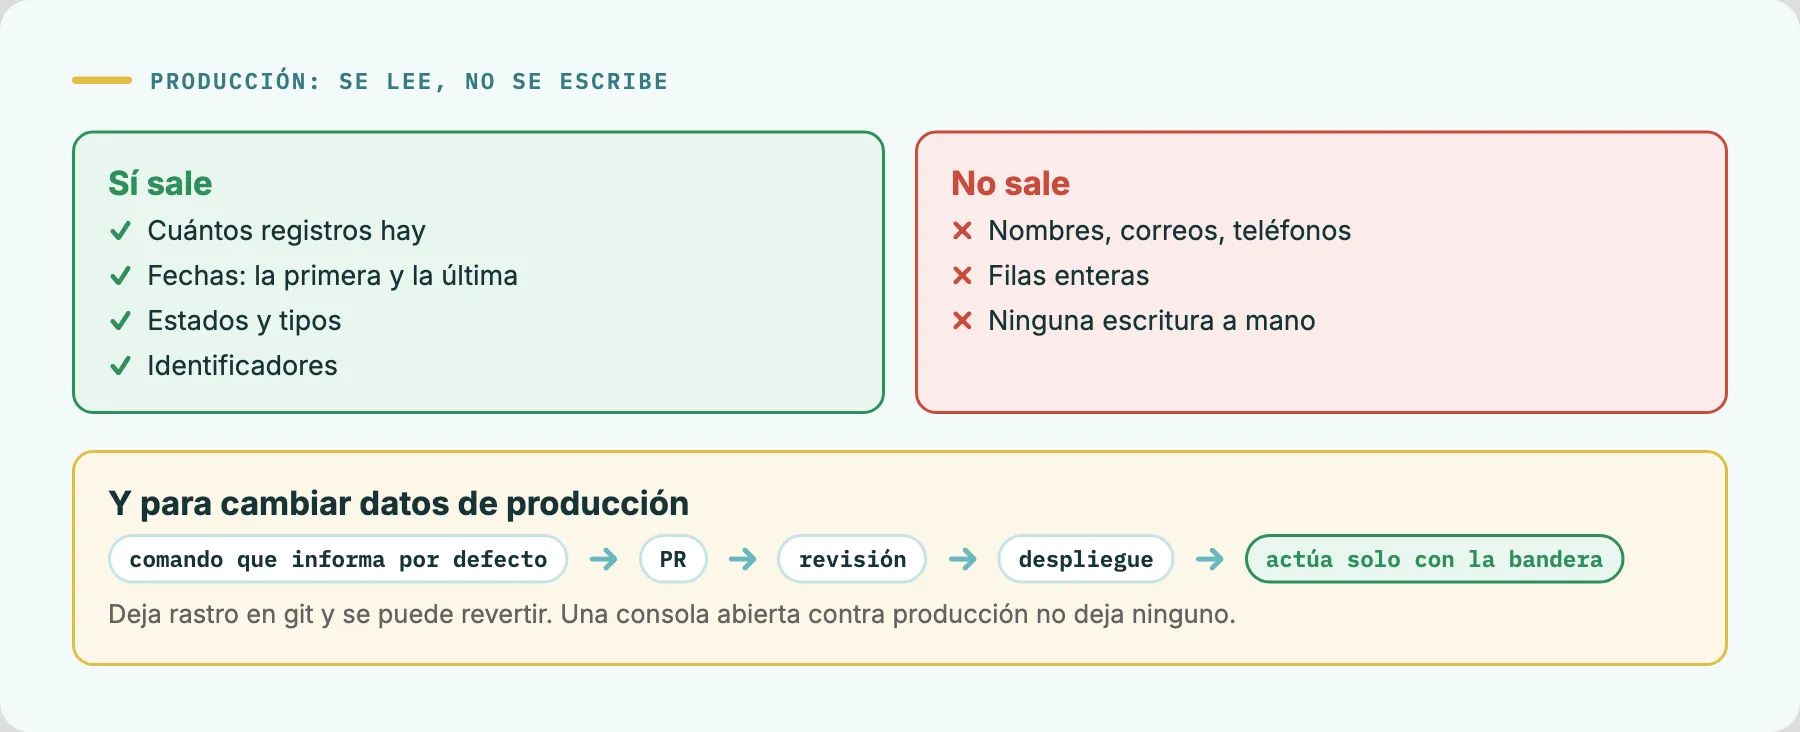
- Antes de cada orden de terminal, otra guarda que deja producción en solo lectura. De allí solo salen agregados (cuántos, desde cuándo) y nunca campos con datos personales.
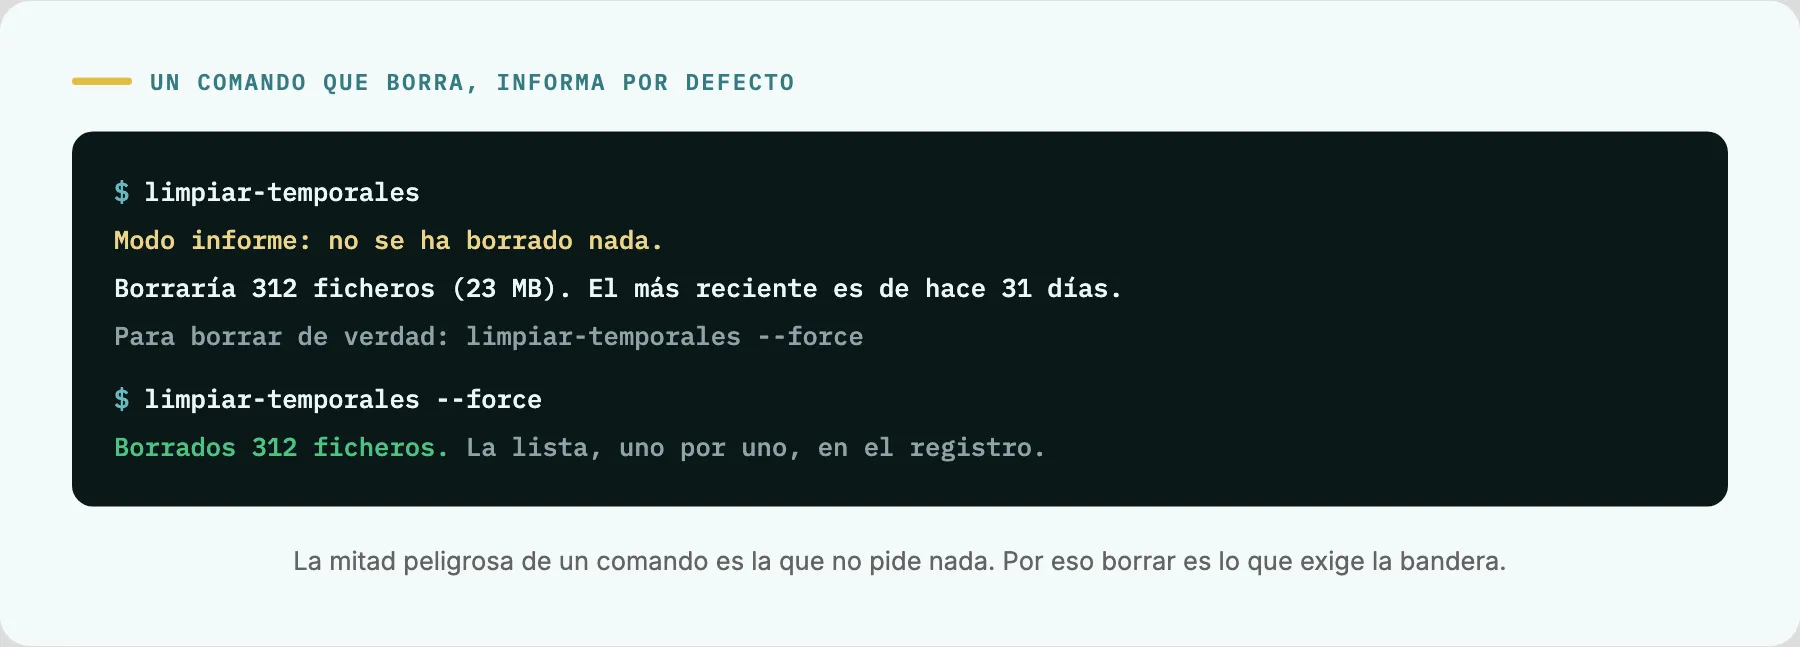
Cambiar datos de producción sí se puede, pero por un solo camino: con un comando que por defecto solo informa de lo que haría y únicamente actúa con una bandera explícita, llega en una PR, se revisa y se despliega. Cuesta unas horas más, pero deja rastro en git y se puede revertir. Una consola abierta contra producción solo existe en el historial de una conversación.
Las guardas siguen unos cuantos principios que hemos aprendido a base de equivocarnos:
Siempre lista blanca. Una guarda que enumera lo peligroso te protege del error de ayer. Una que enumera lo permitido te protege también del de mañana. Lo aplicamos igual dentro del código, por ejemplo en la comprobación que decide si un comando puede borrar datos:
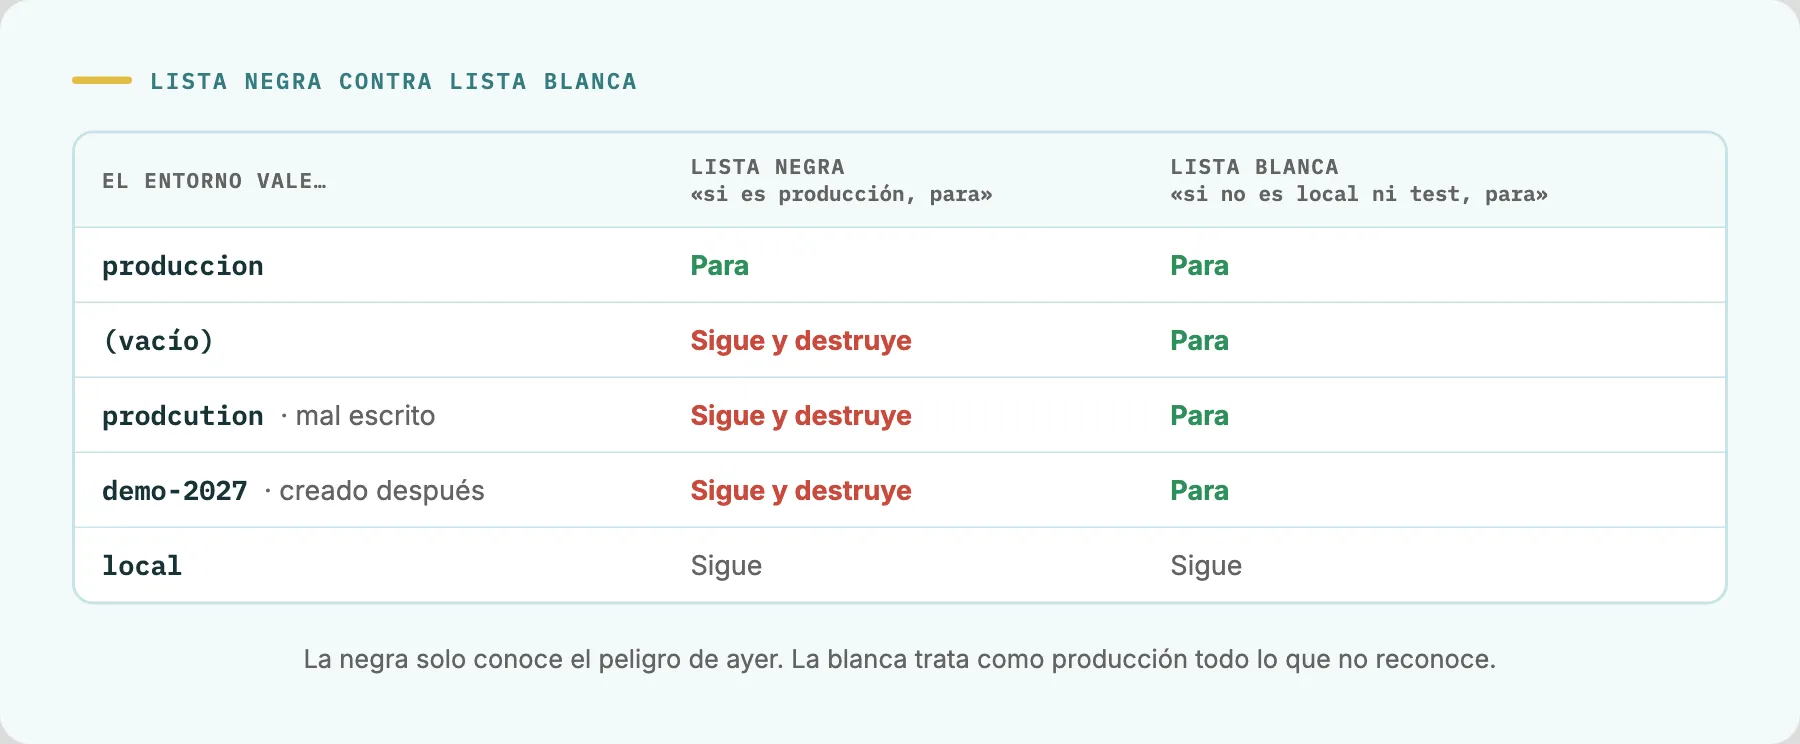
La lista negra deja pasar, y destruye, si la variable de entorno viene vacía, mal escrita o con el nombre de un entorno creado después. La blanca trata como producción todo lo que no reconoce.
Si no puede comprobar, bloquea. Si a una guarda le falta una herramienta, no tiene red o la máquina va tan cargada que no llega a comprobar a tiempo, no deja pasar. Bloquea y dice por qué.
Una guarda que molesta acaba desactivada. Un falso positivo cuesta más de lo que parece: la tercera vez que una guarda bloquea algo inofensivo, alguien busca la forma de apagarla. Por eso el test de las guardas empieza por los falsos positivos.
Las guardas también tienen tests. Ahora mismo son 326 casos, cada uno con su entrada y el resultado que se espera. Además, cada guarda tiene una mutación: una versión rota a propósito que el test tiene que detectar. Si una mutación sobrevive, falta un caso.
Cada hook tiene que ganarse el sitio. Solo automatizamos un fallo cuando cumple dos condiciones: es silencioso (no da error, o el error habla de otra cosa) y una máquina lo puede detectar. Por eso no hay un hook que corra la suite entera en cada edición, ni uno que verifique el cierre al terminar cada sesión. El primero costaría minutos en cada cambio. El segundo tendría tantos falsos positivos que lo desactivaríamos en una semana.
El verde caduca
La guarda del merge merece su propio apartado, porque resuelve el problema más propio de trabajar con varios agentes a la vez.
Una PR en verde está en verde respecto al main que había cuando corrieron sus tests. Si mientras tanto otra tarea mergea por debajo, ese verde ya no vale, y GitHub no vuelve a correr los tests por su cuenta. Con varias sesiones en paralelo, esto pasa todos los días.
Así que antes de cada merge la guarda decide. Comprueba que la PR está en verde y que lo que se va a mergear es exactamente lo que se probó. Luego mira si main ha avanzado. Si lo que ha entrado y lo que quieres mergear tocan ficheros distintos, deja pasar. Si se tocan, o si cualquiera de los dos cambia algo que altera el entorno de los tests (dependencias, configuración, migraciones de base de datos, rutas), bloquea. Entonces toca rebase, volver a pasar CI y volver a intentarlo.
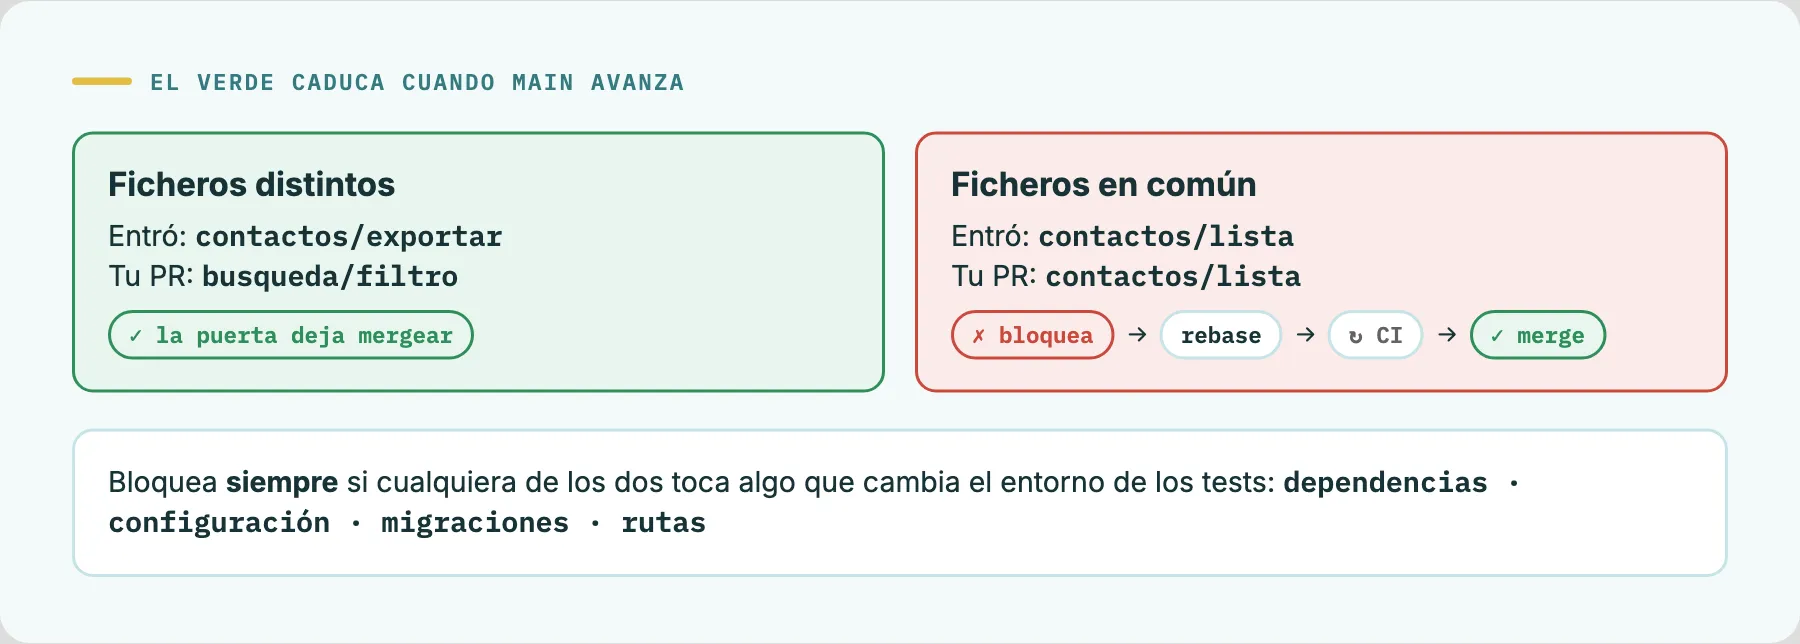
Es el caso que se ve en la animación: dos tareas en el mismo repositorio, la primera entra, y la segunda se encuentra la puerta cerrada hasta que se pone al día.
Cada minuto de CI cuenta
Los minutos de GitHub Actions se pagan, y con varias sesiones empujando a la vez se van muy rápido. Llegamos a quedarnos sin ellos a mitad de mes. Desde entonces, cada pieza de CI tiene que justificar lo que cuesta, igual que las guardas.
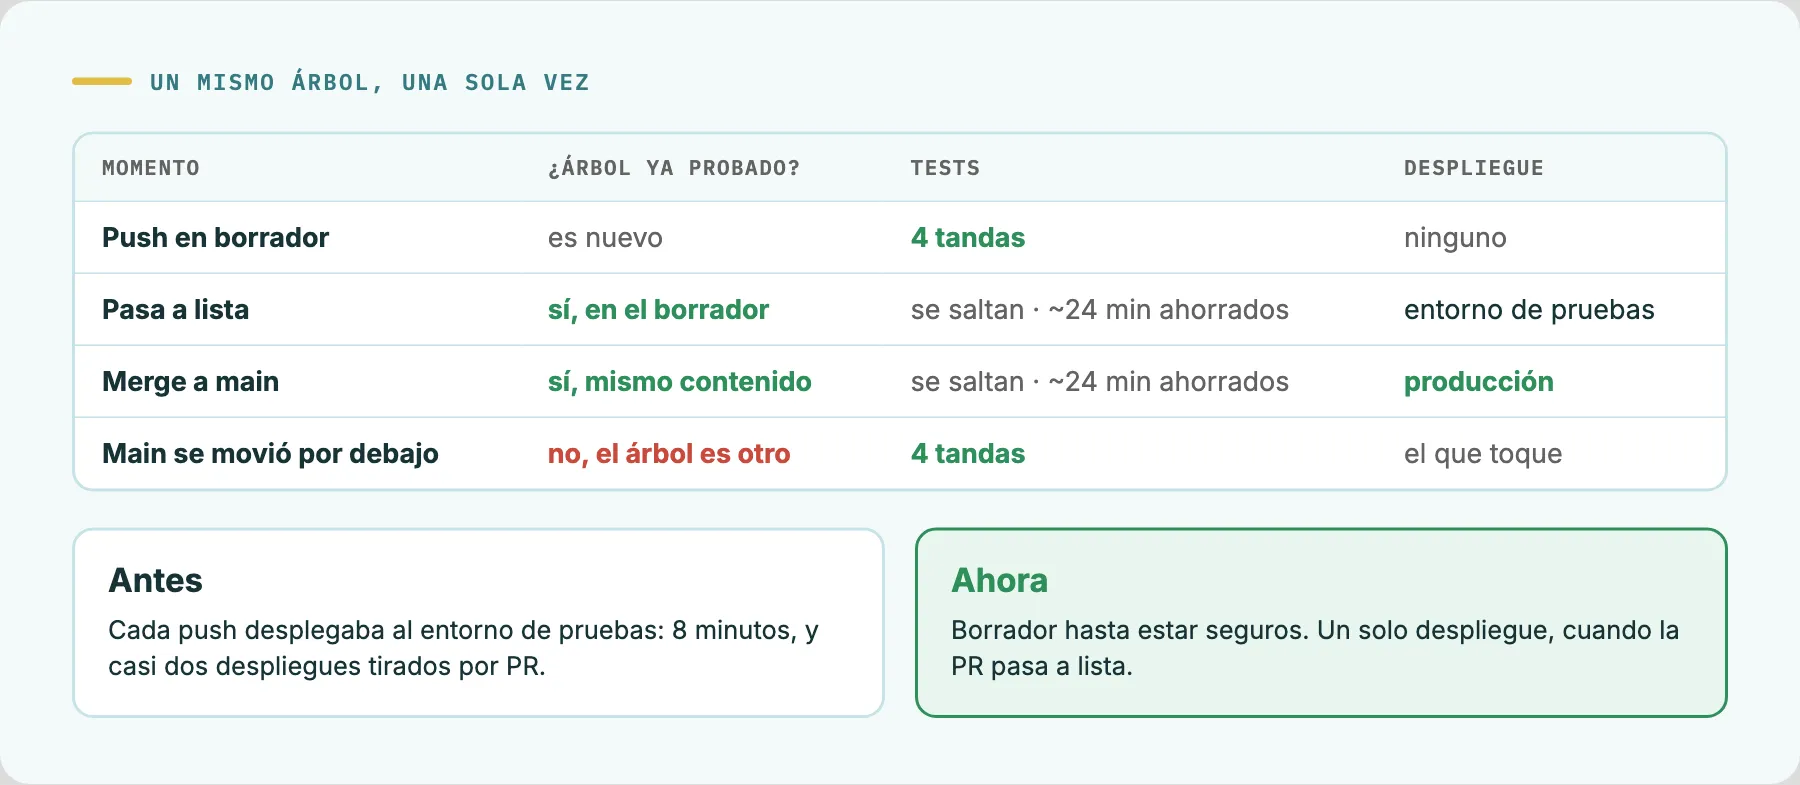
La PR nace en borrador y no pasa a lista hasta que estamos seguros. En borrador corren los tests, pero no se despliega nada. Antes, cada push desplegaba al entorno de pruebas: unos 8 minutos por despliegue, y casi dos despliegues tirados por PR, porque el siguiente push los dejaba viejos. Ahora la PR pasa a lista solo cuando el cierre está hecho y los tests del borrador están en verde. Es entonces, y solo entonces, cuando despliega.
Un árbol que ya pasó no se vuelve a probar. Al pasar a lista, GitHub lanzaba otra vez la suite entera sobre el mismo commit que el borrador acababa de aprobar. Y al mergear, otra vez, sobre un commit nuevo con exactamente el mismo contenido. Ahora el primer paso de CI mira el contenido exacto que va a probar, sin importar la rama ni el commit, y pregunta si ya pasó todos los tests. Si la respuesta es sí, la suite se salta, y son unos 24 minutos de runner cada vez. Si main ha cambiado por debajo, el árbol es otro y los tests corren, como debe ser.
No usamos la cola de merge de GitHub. Resolvería la carrera entre PRs que tocan lo mismo, pero vuelve a correr CI para cada PR que entra en la cola. Y la alternativa habitual, exigir que la rama esté al día con main, obliga a rebase y suite completa cada vez que main se mueve, aunque lo que haya entrado no tenga nada que ver. La puerta que contamos antes hace el mismo trabajo pidiendo solo lo necesario: si los cambios no se tocan, el verde vale; si se tocan, otra vuelta.
Mutación, solo sobre lo que cambia. Las pruebas de mutación meten pequeños errores a propósito y comprueban si los tests se dan cuenta. En la aplicación mutábamos los ficheros enteros que tocaba cada cambio, casi diez minutos por tarea. Ahora cada tarea muta solo lo que su cambio añade: quita cada condición nueva, una a una, y comprueba que algún test cae. Tarda segundos. También apagamos la medición semanal del código entero: costaba miles de minutos de CI al mes y casi nunca llegaba al final. En la plataforma de eventos, donde mutar los ficheros tocados cuesta menos de un minuto, esa pasada sigue además dentro del cierre.
Y lo que se puede romper, mejor romperlo en local. Cada push en rojo es otro pipeline completo. El cierre obligatorio existe también por eso: lo que encuentra en local no gasta ni un minuto de CI.
El bucle que aprende
Todo lo anterior evita los errores que ya conocemos. Pero los que más duelen son los nuevos, y para esos hay un bucle con dos entradas.
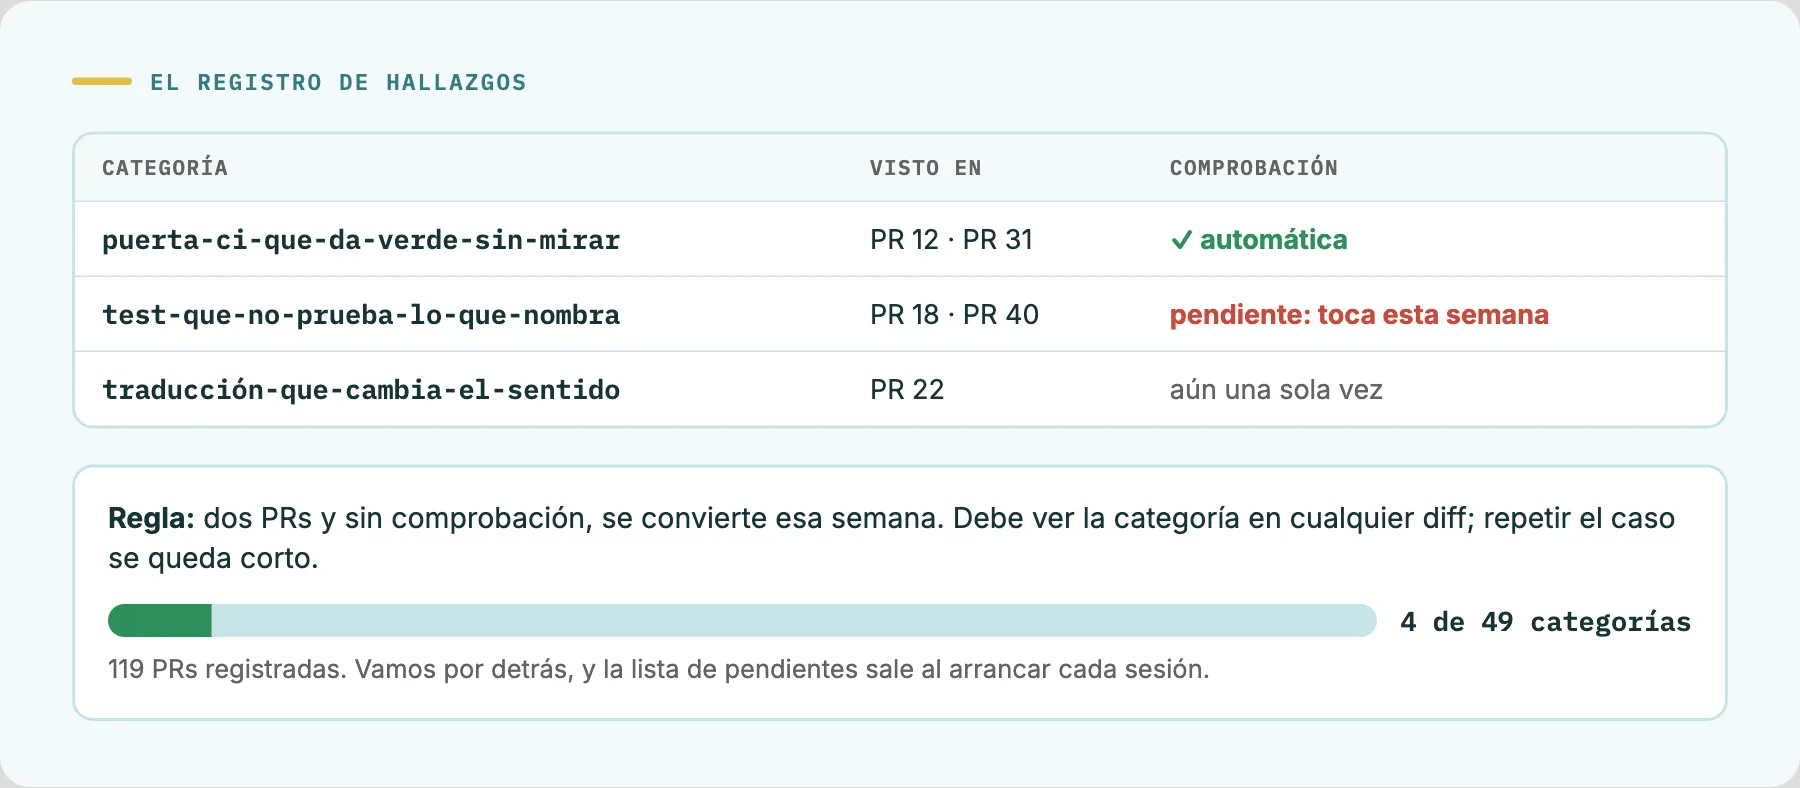
Los hallazgos de las revisiones. Cada hallazgo del revisor de cierre se apunta en un registro con una categoría: «test que no prueba lo que dice», «fallo que sale en silencio», «traducción que cambia el sentido». La regla es que una categoría que aparece en dos PRs y aún no tiene comprobación automática se convierte en una esa misma semana. Esa comprobación tiene que detectar la categoría en cualquier diff; repetir el test del caso que la destapó se queda corto.
Hay que ser sinceros con los números. Llevamos 119 PRs registradas, 49 categorías distintas, y solo 4 se han convertido ya en comprobación automática. Escribir una comprobación que vea una categoría entera sin dar falsos positivos es difícil, y una mala comprobación es peor que ninguna. Lo que sí está automatizado es el recordatorio: cada sesión arranca con la lista de categorías pendientes delante.
Los incidentes. Con todo esto, las cosas se siguen rompiendo. Casi siempre por alguno de estos motivos:
- Lo que no da error. Una configuración que apunta al entorno equivocado, un test que pasa sin probar nada o un dato que se calcula sobre una fuente que ya no existe. Todo en verde, y todo mal.
- Dos cambios correctos que juntos no lo son. Cada PR pasa sus tests por separado y el problema solo aparece cuando conviven en main.
- Lo que solo pasa en un entorno. Las pruebas locales y CI usan bases de datos distintas, y lo que una tolera, la otra lo rechaza. O una variable que nadie fijó y que en tu máquina vale otra cosa.
- Los comandos cuya mitad peligrosa es la que no pide nada. Un comando que borra cuando lo ejecutas sin argumentos es una trampa esperando a alguien con prisa. Por eso todo comando que borra, trunca o sobrescribe datos informa por defecto y solo actúa con una bandera explícita.
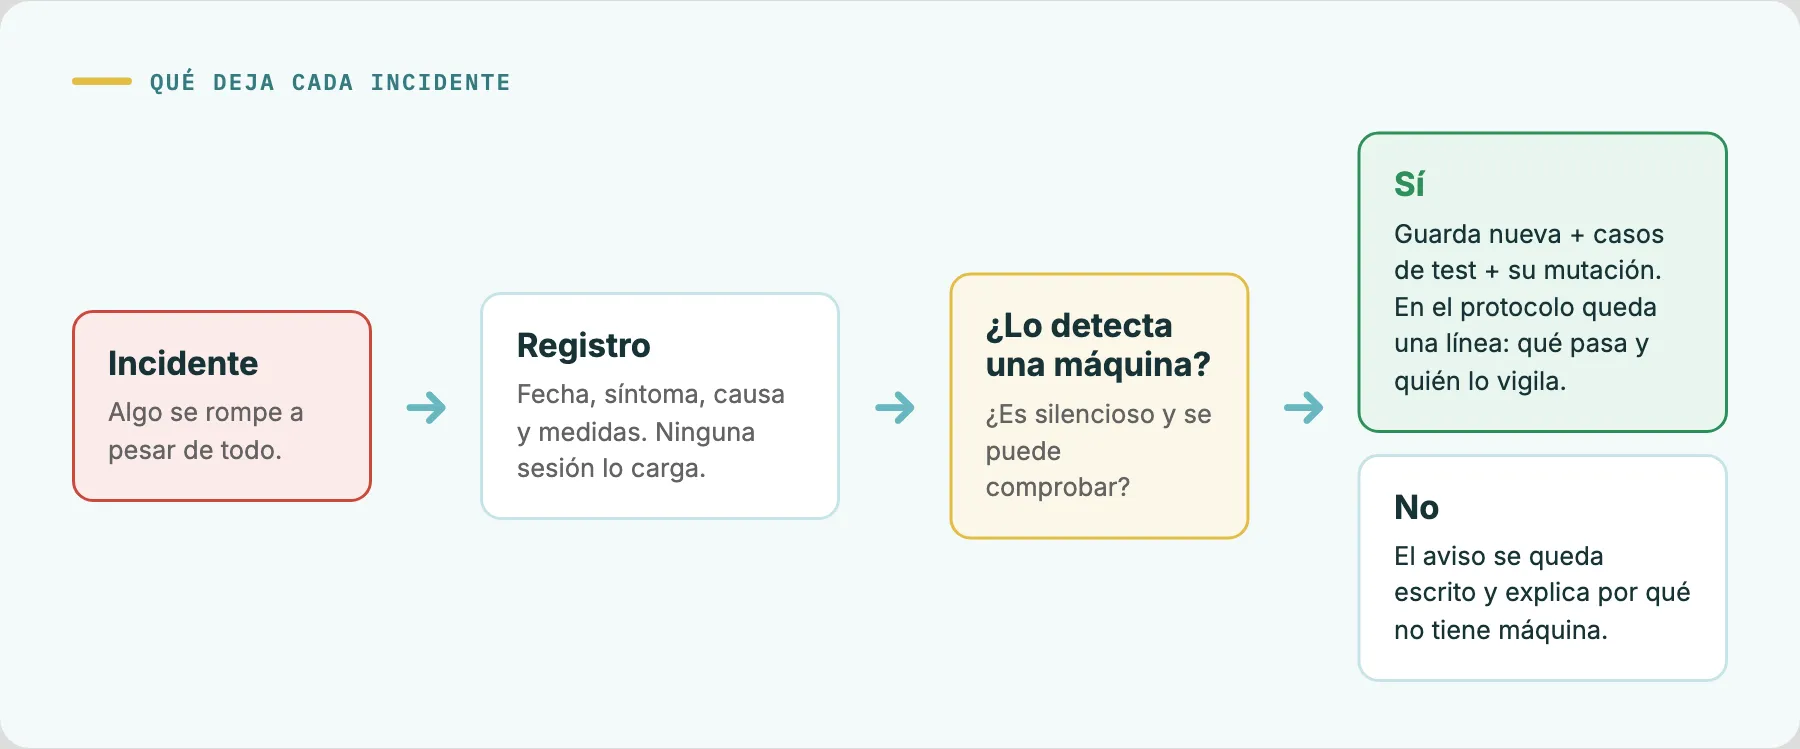
Cada incidente se apunta con su fecha, su síntoma, su causa y las medidas tomadas. Si una máquina puede detectarlo, se convierte en una guarda con sus casos de test y su mutación, y en el protocolo queda una sola línea. Si no puede, el aviso se queda escrito y explica por qué no tiene máquina detrás.
¿Es esto una software factory?
Ahora todo el mundo habla de software factories: agentes que reciben una idea por un lado y entregan software terminado por el otro. La pregunta es inevitable, y la respuesta corta es que solo en parte.
Hay cosas que sí son de fábrica. Hay una línea con estaciones fijas, y cada repositorio tiene la suya. Las guardas hacen lo que en una planta hacen los sistemas a prueba de errores: hacen que el fallo no pueda ocurrir. La línea se para sola cuando algo va mal, con un CI en rojo o un merge que choca con otro. Y hay mejora continua, porque cada error que se repite tiene que acabar convertido en una comprobación.
Pero hay otras que no. Qué se construye, cuándo empieza una tarea y si está bien planteada lo seguimos decidiendo nosotros. No hay una cola que se procese sola desde el backlog hasta producción. Y la mejora continua va por detrás, como cuentan esos 4 de 49.
Por eso preferimos otro nombre para lo que hemos construido: el control de calidad de una fábrica de software. Los agentes producen y la línea decide qué pasa.
Lo que nos llevamos
- El contexto es presupuesto. Un protocolo que nadie lee no protege de nada. Es mejor una línea con una máquina detrás que un párrafo bien escrito.
- Quien escribe no revisa. Un revisor sin contexto encuentra lo que el autor ya no puede ver, ya sea una persona o un agente.
- Máquinas antes que memoria. Todo lo que se puede comprobar se comprueba solo, y todo lo que no, se escribe con su porqué.
- No todo merece una máquina. Una comprobación que cuesta minutos en cada cambio, o que molesta más de lo que protege, acaba desactivada. Cada pieza tiene que pagarse en el tiempo que ahorra.
Trabajar así nos da tranquilidad. La mayor parte de lo que podría salir mal se para antes de llegar a producción, y lo que llega deja algo aprendido para la próxima vez.
Si también trabajas con agentes y quieres comparar notas, escríbenos. Nos encanta hablar de esto.
