Ce que nous avons appris en montant des hooks dans Claude Code (et ce qu'ils ne font pas, même s'ils en ont l'air)

- Un hook, en quinze lignes
- 1. Le portier trop lent laisse entrer tout le monde
- 2. L’alarme qui sonne à la cave
- 3. L’alarme installée mais pas branchée
- 4. Le filtre qui ne te laisse pas expliquer le filtre
- 5. La liste des indésirables contre la liste des invités
- 6. Un panneau n’est pas un tourniquet
- 7. Deux personnes modifient le même document et l’une enregistre une vieille copie par-dessus
- Ce que nous avons retiré
- Un hook, c’est du code de production
Il y a quelques semaines, nous avons raconté comment nous travaillons avec Claude Code : dix dépôts, plusieurs agents qui programment en même temps et une règle de fond, qu’aucune règle importante ne dépende du fait que quelqu’un s’en souvienne.
La pièce qui tient cette règle, ce sont les hooks. Un hook est un petit programme que Claude Code exécute à des moments fixes : au démarrage de la session, après chaque modification d’un fichier, avant chaque commande dans le terminal. Et il peut dire « non » : si la commande est dangereuse, il la bloque avant qu’elle ne s’exécute.
Pense au contrôle de sécurité d’un aéroport. Personne ne compte sur chaque passager pour se rappeler ce qu’il n’a pas le droit d’emporter : il y a un portique et un tapis par lesquels tout le monde passe. Les hooks sont ce portique pour les agents.
Dans un aéroport, il est très rare que le portique tombe en panne sans que personne ne s’en aperçoive. Il a un voyant qui dit s’il est allumé, un agent à côté et un test chaque matin avec un objet métallique. Un hook n’a rien de tout ça : s’il ne s’exécute pas, s’il manque de temps ou s’il crie là où personne n’écoute, tout reste au vert. Ces vérifications, c’est à toi de les mettre en place.
C’est le sujet de cet article : sept façons dont nos hooks ont échoué sans rien dire, comment nous nous en sommes rendu compte et ce que nous avons changé. Si tu utilises des hooks, ou n’importe quel automatisme qui sert de garde, il y a de bonnes chances que tu tombes sur l’une d’elles.
Un hook, en quinze lignes
Avant les pièges, voyons à quoi ressemble un hook de l’intérieur. Celui-ci bloque toute tentative d’envoyer des changements directement sur la branche principale (git push vers main). Ce n’est pas notre vraie garde, qui en fait bien plus, mais il fonctionne et on peut le copier.
D’abord, la ligne qui le branche. Elle va dans .claude/settings.json, à l’intérieur du projet :
{
  "hooks": {
    "PreToolUse": [
      {
        "matcher": "Bash",
        "hooks": [
          {
            "type": "command",
            "command": "sh \"$CLAUDE_PROJECT_DIR/.claude/hooks/no-push-main.sh\"",
            "timeout": 10
          }
        ]
      }
    ]
  }
}
En clair : avant chaque commande de terminal (PreToolUse avec Bash), exécute ce script, et donne-lui dix secondes au maximum.
Et le script :
#!/bin/sh
# Bloque `git push` vers main. Claude Code passe la commande en JSON sur l'entrée standard.
# Sortir avec 2 la bloque, et ce qui est écrit sur stderr arrive à l'agent comme motif.

orden=$(jq -r '.tool_input.command // empty') || {
  echo "Je ne peux pas lire la commande (jq manque ?). Je la bloque par précaution." >&2
  exit 2
}

# Ne compte que si git est là où le terminal l'exécuterait : au début ou après ; & | (
# Un grep ou un echo qui mentionnent « git push origin main » passent.
if printf '%s\n' "$orden" | grep -Eq '(^|[;&|(])[[:space:]]*((rtk|sudo)[[:space:]]+)?git([[:space:]]+-C[[:space:]]+[^[:space:]]+)?[[:space:]]+push([[:space:]]+[^;&|]*)?([[:space:]]|:)(refs/heads/)?main([[:space:];&|)]|$)'; then
  echo "On n'arrive sur main que par une PR : pousse ta branche et ouvres-en une." >&2
  exit 2
fi
exit 0
Quand l’agent tente git push origin main, la commande ne s’exécute pas et l’agent reçoit le motif. Lors d’une session de test, il a répondu ainsi : « Le push vers main a été bloqué : un hook du projet répond “On n’arrive sur main que par une PR : pousse ta branche et ouvres-en une” ». Et au lieu d’insister, il continue par le chemin que tu lui as indiqué.
Ces quinze lignes contiennent déjà trois des leçons qui suivent : s’il ne peut pas lire la commande, il bloque ; il distingue l’exécution d’une commande de sa simple mention ; et le motif passe par le canal que l’agent lit vraiment. Les sept pièges expliquent pourquoi chaque détail est là.
1. Le portier trop lent laisse entrer tout le monde
Imagine un portier qui, avant de laisser entrer qui que ce soit, téléphone pour vérifier la liste. Un jour, la ligne est lente. Le plus logique serait que personne n’entre tant que le portier n’a pas de réponse. Ce qui se passe en réalité, c’est qu’au bout d’un moment, la porte s’ouvre toute seule.
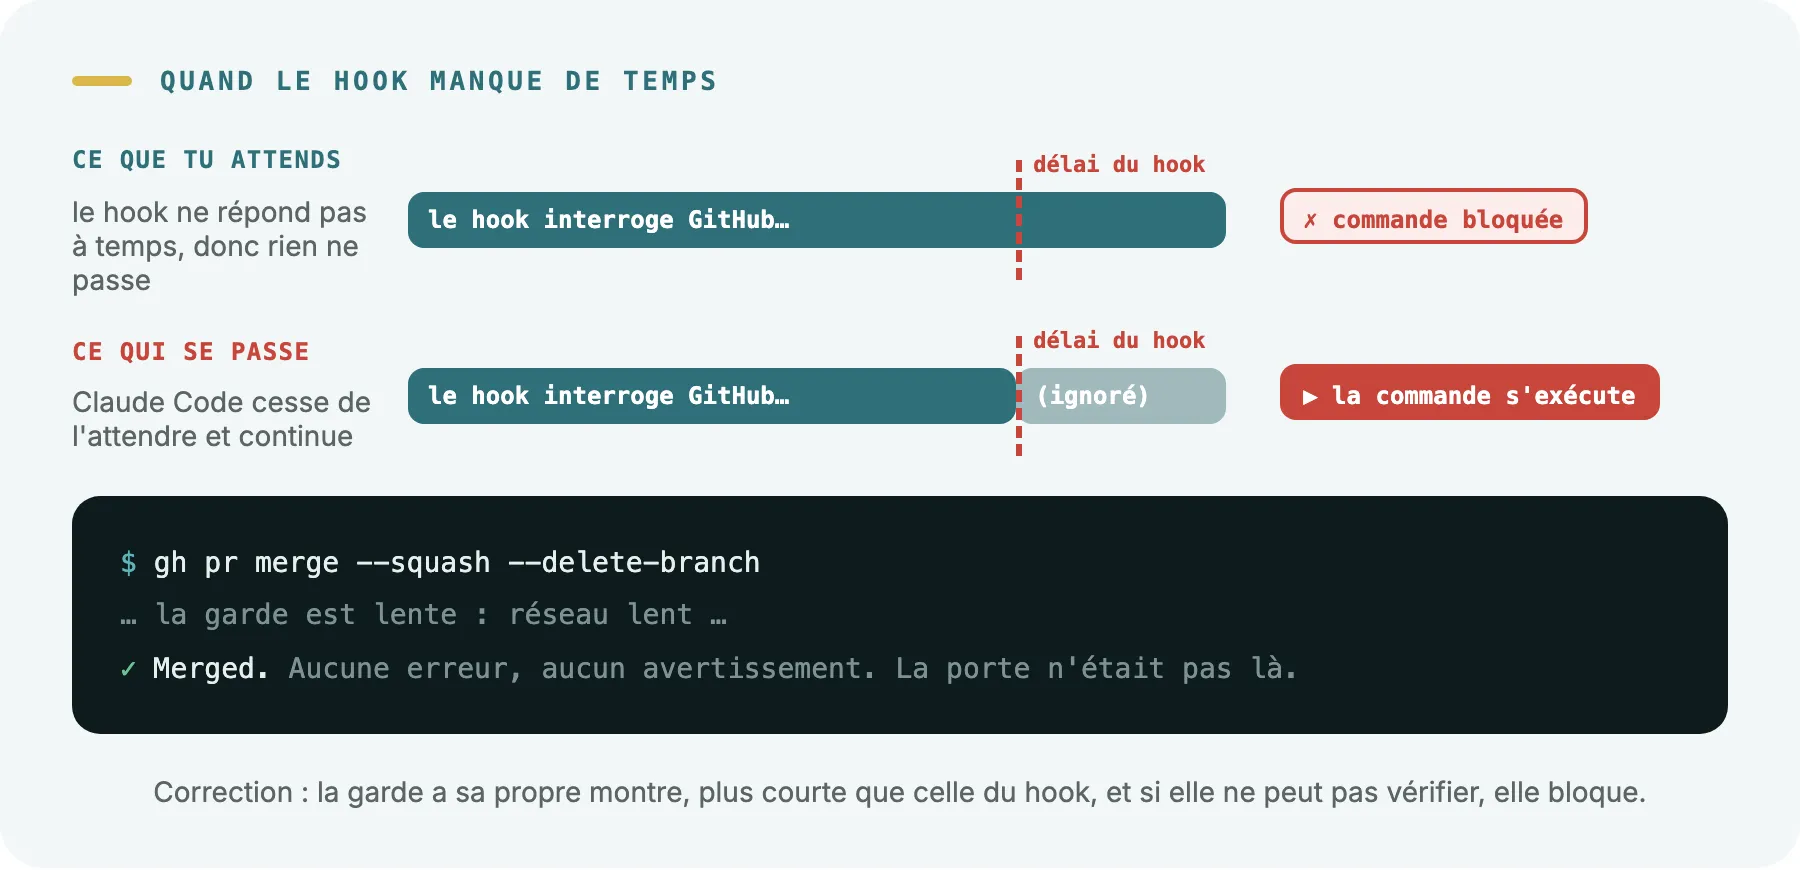
C’est ce que fait un hook quand il manque de temps. Chaque hook a un délai maximal, et nous supposions que, s’il était dépassé, la commande restait bloquée. Ce n’est pas le cas. Nous l’avons mesuré avec un hook de test qui avait deux secondes de délai, en mettait six et finissait par dire « non » : la commande s’est exécutée quand même. Le journal du hook contenait la ligne de début et jamais celle de fin, parce que Claude Code l’avait coupé avant qu’il puisse dire quoi que ce soit.
Nous avons refait l’essai en écrivant cet article, avec la version 2.1.318 de Claude Code, et à côté d’un hook témoin identique mais rapide. Le rapide a bloqué la commande et le lent l’a laissée passer.
Dans notre flux, la CI lance les tests et déploie, mais c’est l’agent qui appuie sur le bouton de merge, avec une commande dans le terminal. Devant cette commande, il y a une garde : avant de laisser un changement entrer dans la branche principale, celle qui est déployée en production, elle demande à GitHub si les tests sont au vert et si la branche principale a bougé entre-temps. Avec un réseau lent, cette requête mangeait le délai et la porte restait ouverte. Personne n’a vu d’erreur, parce qu’il n’y en a pas eu.
Ce que nous avons changé :
- Le portier a sa propre montre, plus courte que celle de la porte. Chaque garde s’impose une limite de temps pour chaque requête, et elle le fait avant que celle du hook ne soit épuisée.
- Si elle ne peut pas vérifier, elle ne laisse pas passer. Sans réseau, sans un outil dont elle a besoin ou avec l’ordinateur si chargé qu’elle n’arrive pas à temps : elle bloque et explique pourquoi.
- Un test vérifie que les deux montres concordent. Si quelqu’un change l’une sans l’autre, il passe au rouge. Il s’est déjà déclenché une fois : une copie de la garde avait 60 secondes de délai et avait besoin de 120.
Et un aveu : la première version de ce test ne vérifiait rien. Une erreur dans un chemin lui faisait sauter tous les fichiers, et il sortait toujours au vert. Nous l’avons découvert quand nous avons cassé un délai exprès et que le test est resté au vert. Une garde morte se lit aussi bien qu’une garde vivante.
2. L’alarme qui sonne à la cave
L’un de nos hooks examine chaque fichier après que l’agent l’a modifié et signale les problèmes : « il manque son statut à ce plan », « ce document a dépassé sa taille ». Nous le testions à la main et l’avertissement sortait parfaitement.
Pendant des semaines, l’agent n’en a pas reçu un seul.
C’était comme une alarme qui sonne à la cave, où il n’y a personne. Ce que ce type de hook écrit en texte normal part dans le journal que la personne peut lire, pas chez l’agent. Pour que l’agent le reçoive, l’avertissement doit avoir un format précis (un petit JSON avec un champ appelé additionalContext). Dans le hook de démarrage de session, en revanche, le texte normal arrive bien, et c’est pour ça que l’un fonctionnait et que l’autre semblait fonctionner.
Nous avons aussi refait l’essai avec la version 2.1.318. Un hook qui tourne après chaque modification transmettait à l’agent un mot-clé inventé sur le moment, et nous lui demandions ensuite lequel c’était. Quand le hook l’écrivait en texte normal, l’agent répondait « aucun ». Quand il l’écrivait dans le JSON, il répondait le mot exact.
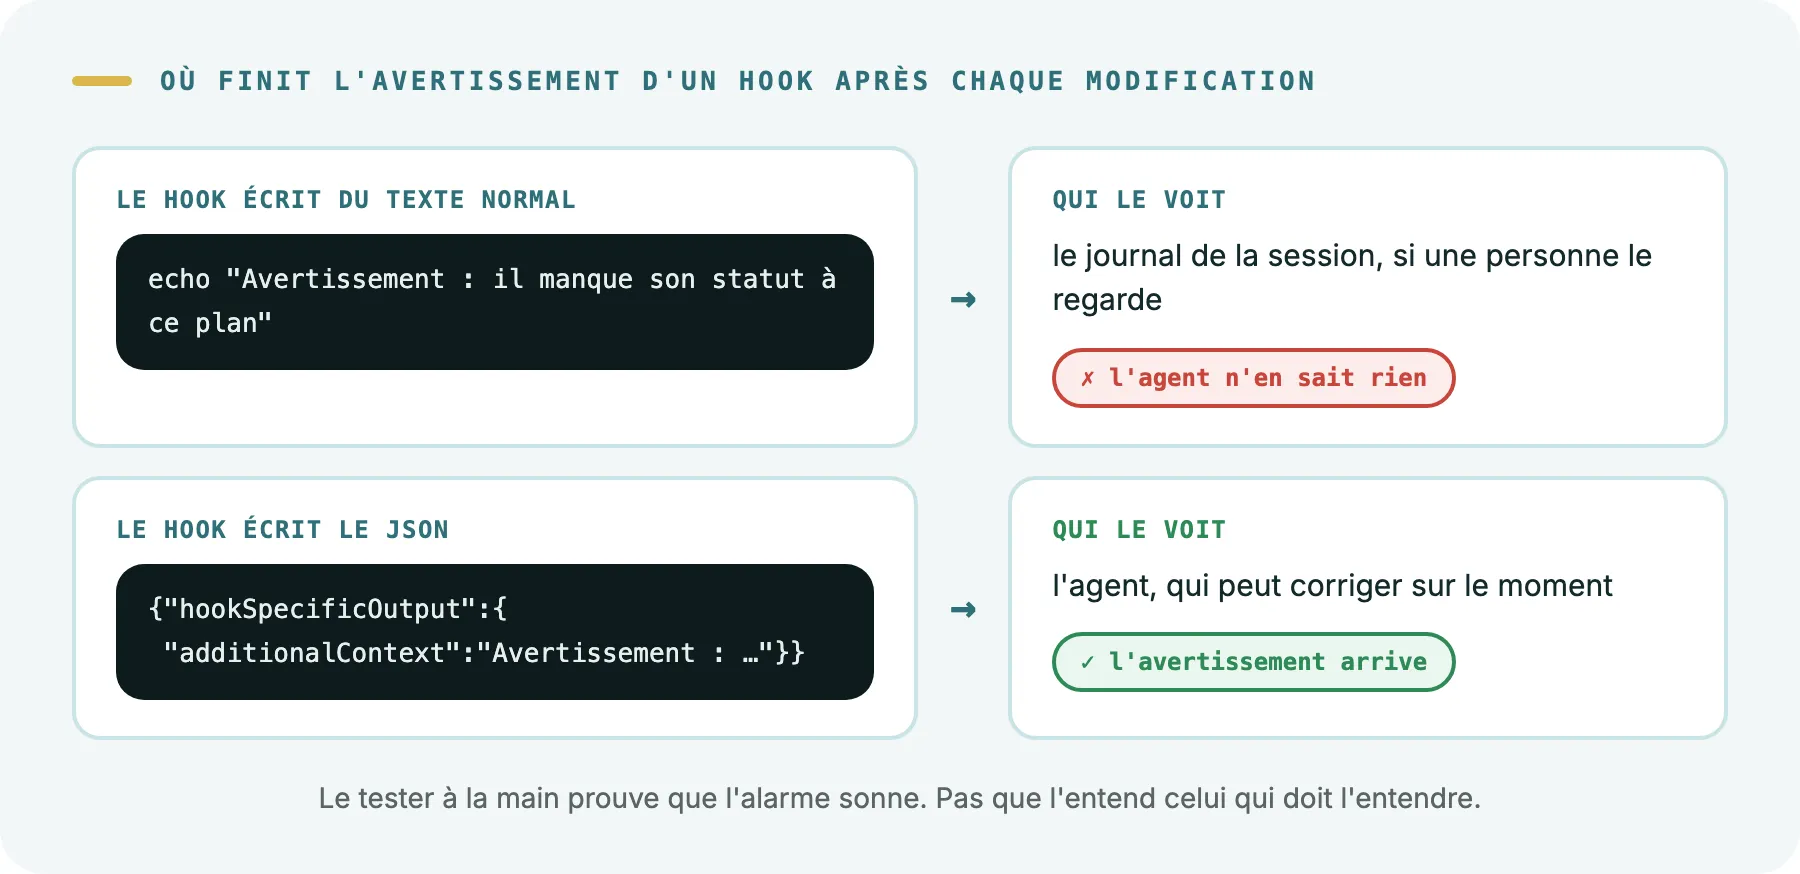
Aujourd’hui, tous les avertissements sortent dans ce format, et un test passe au rouge si quelqu’un se remet à écrire du texte normal.
La leçon générale : vérifier qu’une alarme sonne ne suffit pas. Il faut vérifier que l’entend celui qui doit l’entendre. Avec un hook, cela veut dire provoquer la situation dans une vraie session et voir si l’agent réagit.
3. L’alarme installée mais pas branchée
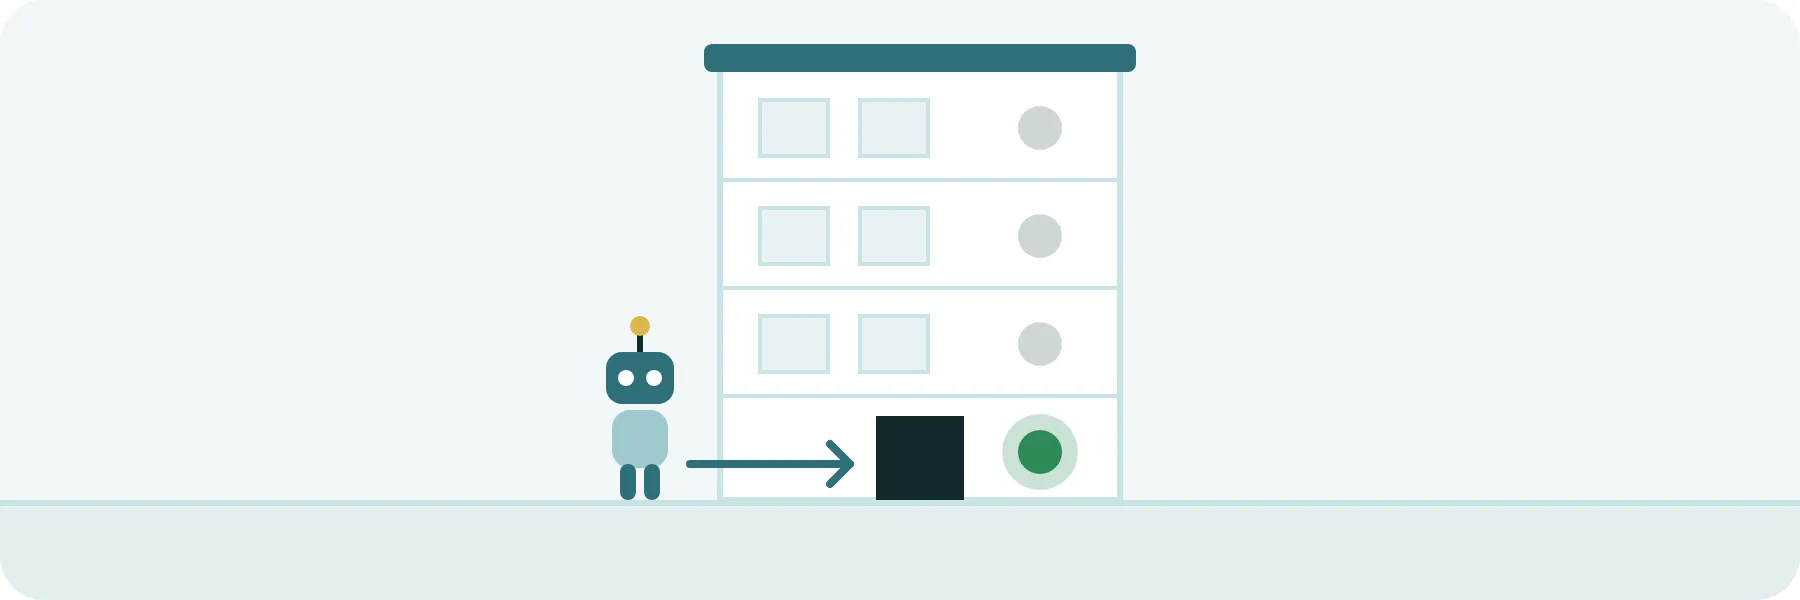
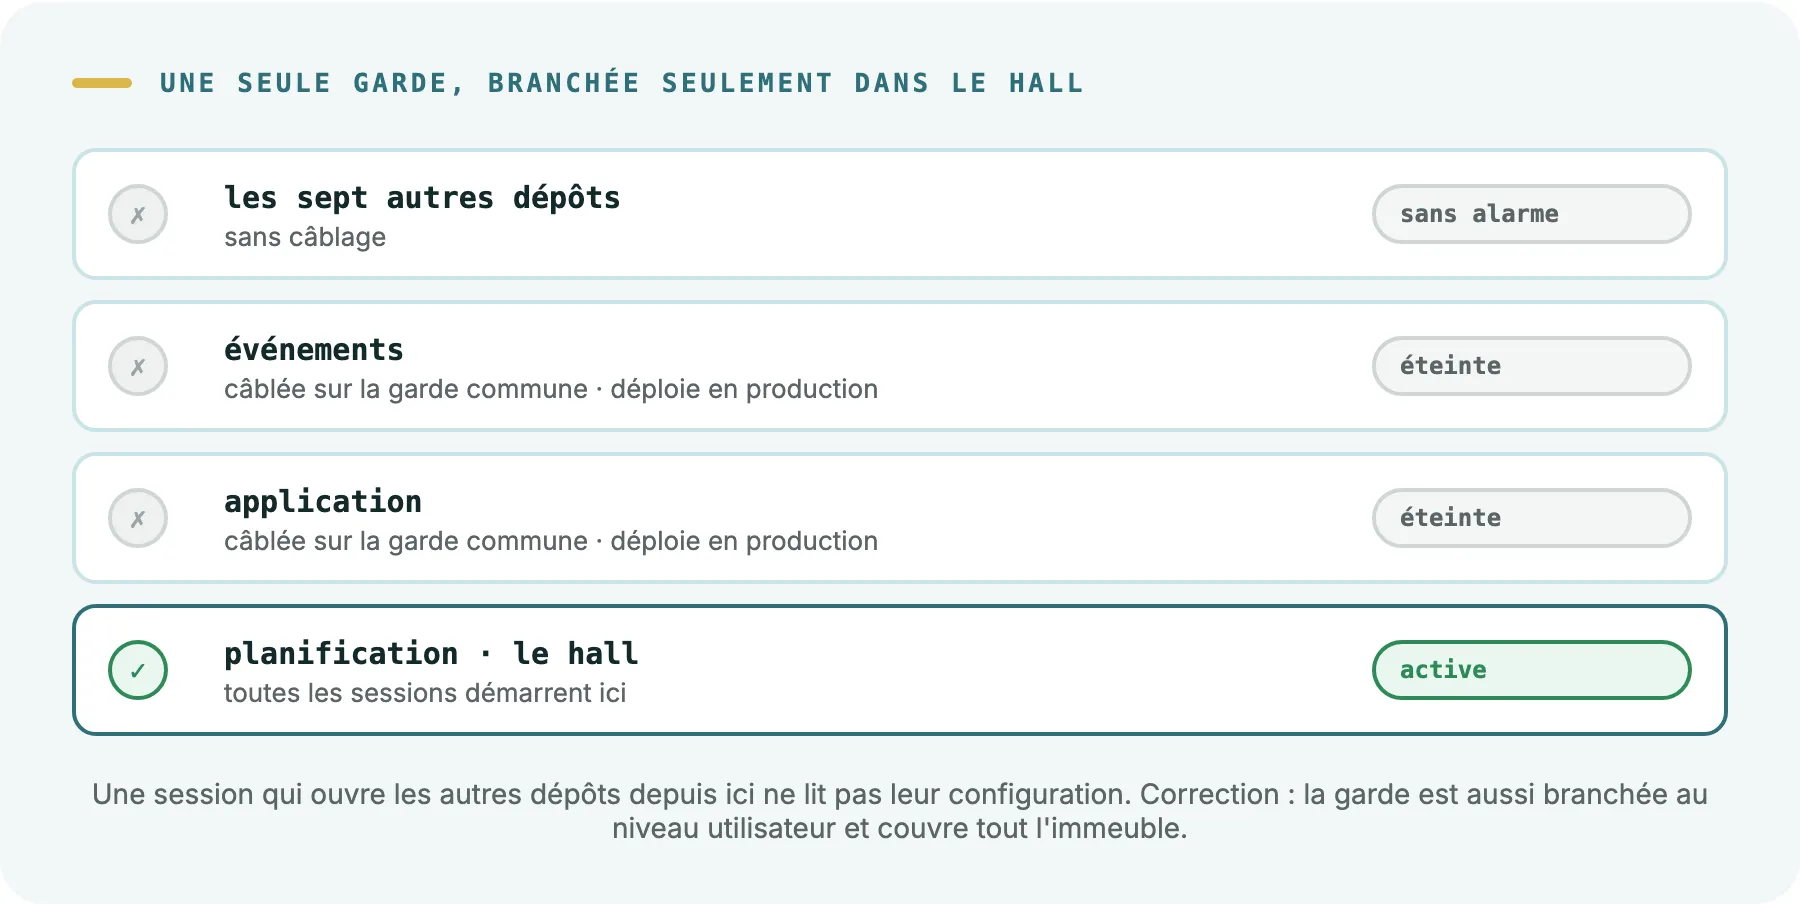
Notre travail est réparti sur dix dépôts. Les gardes sont les mêmes pour tous : une seule copie de chaque script, dans le dépôt de planification. Ce que chaque dépôt possède, c’est le câblage, une ligne dans sa configuration qui dit « avant chaque commande, exécute cette garde ». Les deux principaux, l’application et la plateforme d’événements, l’avaient. Mais nos sessions ne démarrent pas dans un dépôt produit : elles démarrent dans celui de planification et ouvrent les autres depuis là.
Il se trouve que Claude Code lit la configuration à deux endroits : la tienne, au niveau utilisateur, et celle du projet où démarre la session. Celle des dépôts ouverts ensuite, non. Nous l’avons revérifié avec la version 2.1.318 : le même hook qui bloquait une commande quand la session démarrait dans son dépôt ne s’exécutait pas quand ce dépôt était ouvert depuis un autre. C’est comme un immeuble où seule l’alarme du hall est branchée. Tu montais aux étages où se trouve ce qui a de la valeur, et leur alarme, installée et à sa place, était éteinte. Et sept autres étages n’avaient même pas d’alarme.
Le même problème avait deux autres variantes :
- Des hooks qui regardaient le mauvais étage. Certains déduisaient dans quel dépôt ils se trouvaient à partir de l’endroit où la session avait démarré, et non du fichier qui venait d’être modifié. Celui qui formate le code après chaque modification ne s’exécutait jamais dans le mode de travail normal.
- Une garde qui ne regardait que l’endroit d’où partait la commande. Si la commande partait d’un dossier temporaire, la garde s’éteignait, même si la commande visait directement le dépôt à protéger. C’est comme un vigile qui ne contrôle que ceux qui entrent par la porte principale et ne regarde pas où ils vont.
Aujourd’hui, la garde principale est installée au niveau utilisateur, donc elle couvre tout l’immeuble. Les hooks déduisent le dépôt à partir du fichier modifié, et les gardes regardent ce que vise chaque commande, pas l’endroit d’où elle part. Quand elles ne peuvent pas le savoir, elles bloquent tout ce qui est destructeur.
4. Le filtre qui ne te laisse pas expliquer le filtre
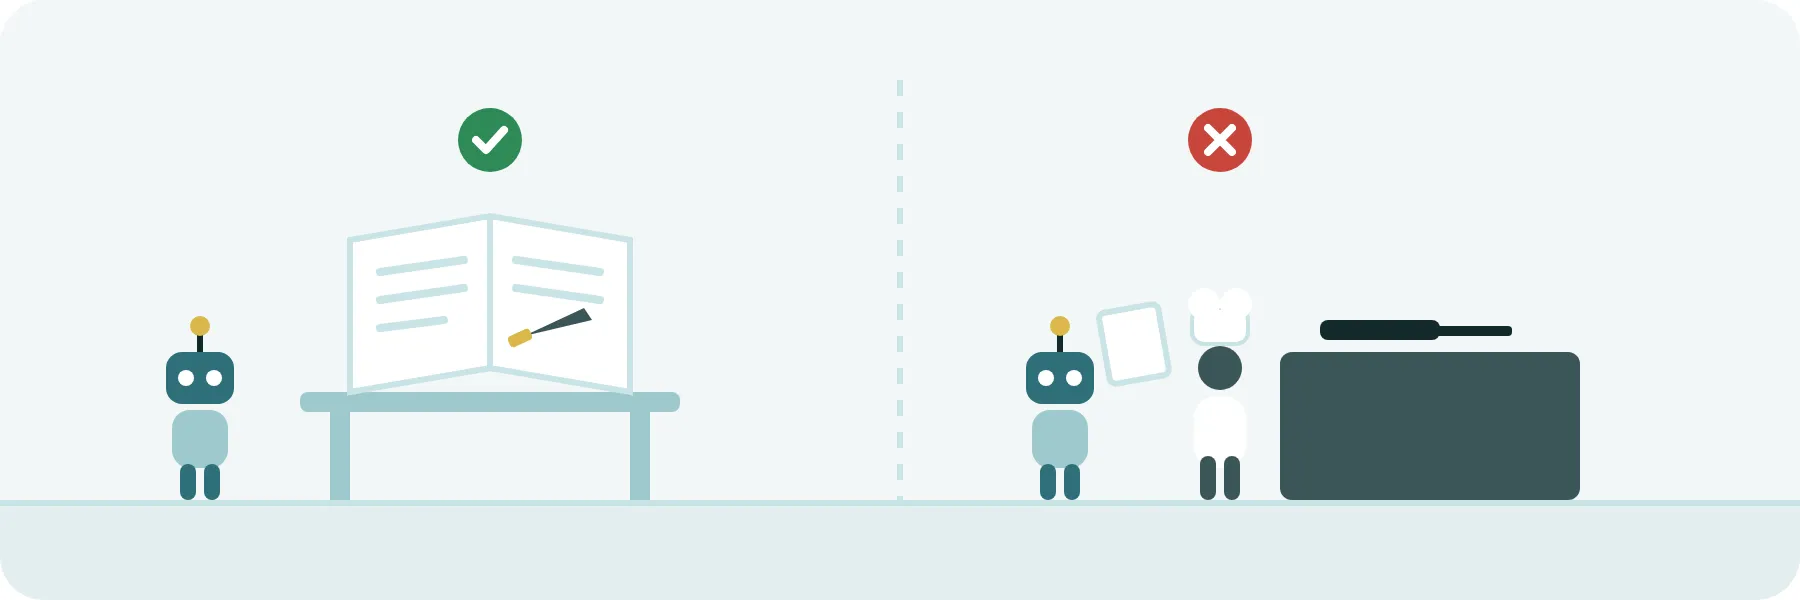
La première version de notre garde cherchait des mots : si la commande contenait le nom d’une commande dangereuse, elle la bloquait. La première chose qu’elle a bloquée, c’est la modification du document qui expliquait pourquoi cette commande était interdite.
C’est comme un filtre anti-spam qui envoie à la corbeille l’e-mail de sécurité qui t’explique comment reconnaître le spam. Ou un détecteur qui ne te laisse pas dire « couteau » pour expliquer qu’on ne peut pas emporter de couteaux.
Une garde comme ça est pire que pas de garde du tout. Elle gêne quand on la documente, quand on la teste et quand on en parle, et à la troisième fois, quelqu’un cherche le moyen de l’éteindre.
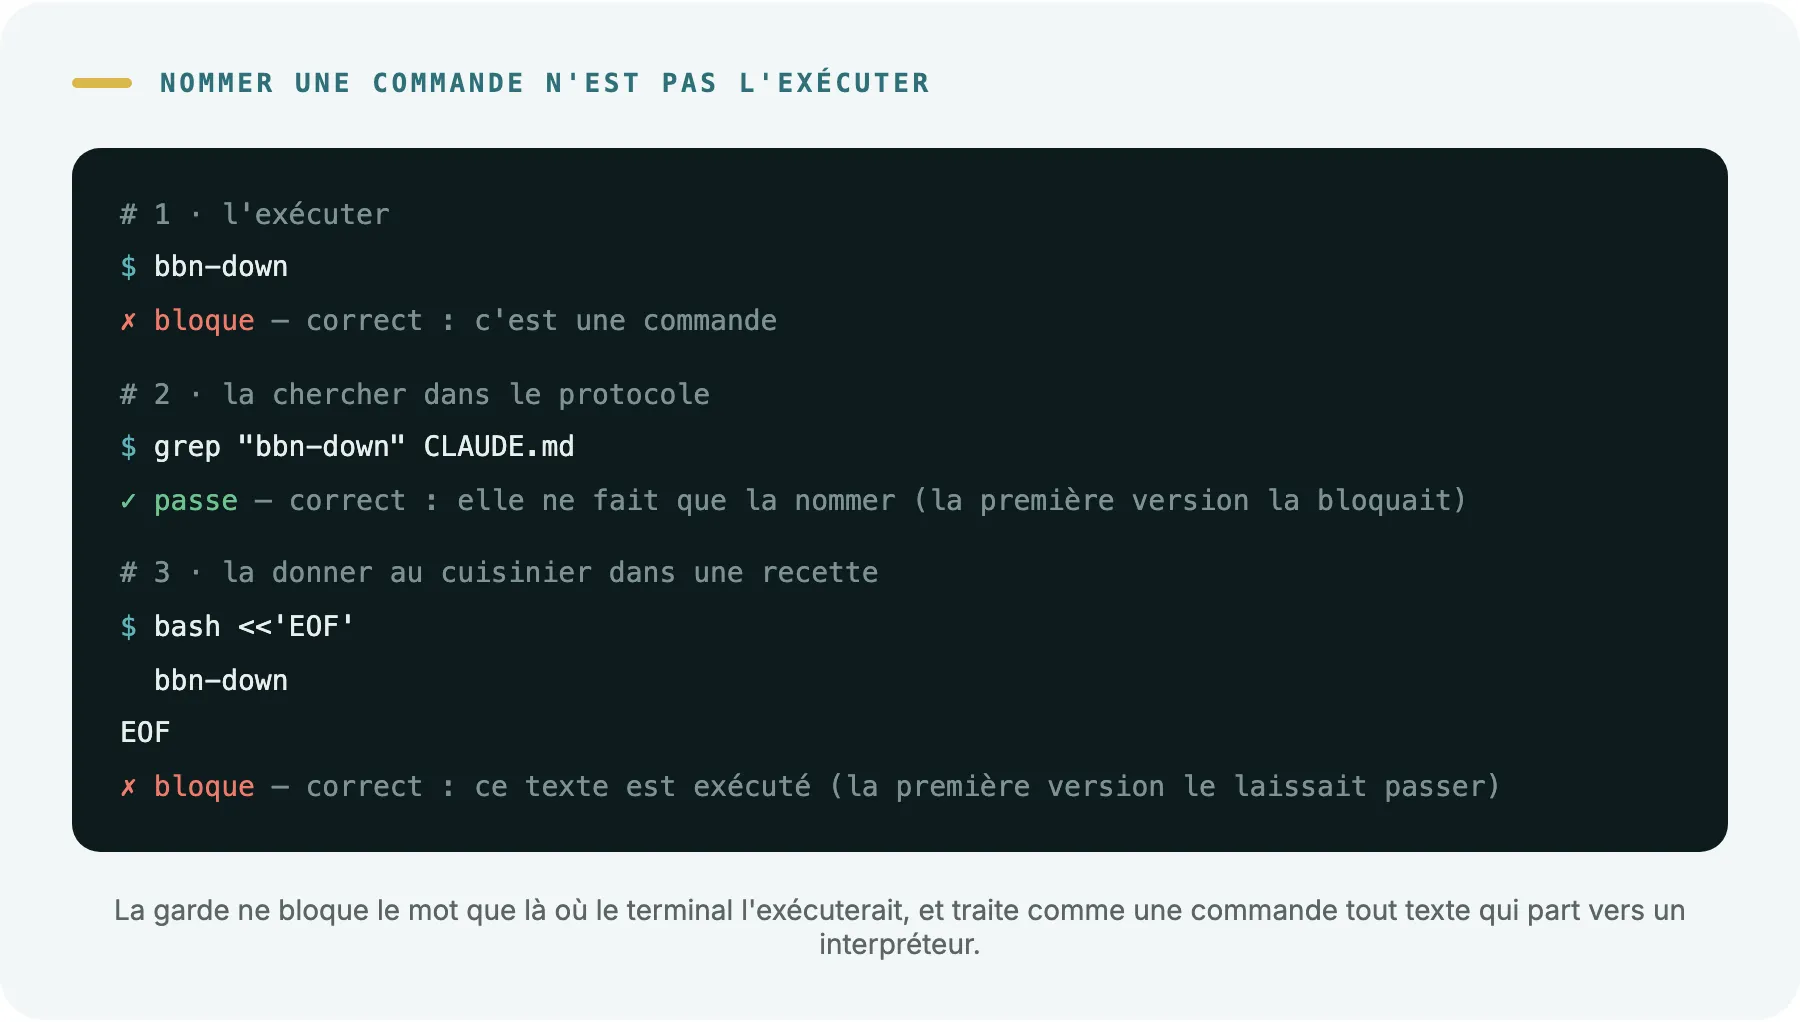
La solution est de distinguer nommer une commande et l’exécuter. La garde ne bloque que quand le mot est à l’endroit où le terminal l’exécuterait : au début de la commande ou juste après les symboles qui enchaînent les commandes. Le chercher dans un fichier ou l’écrire dans un document passe.
Avec une nuance qui nous a valu deux frayeurs : un bloc de texte envoyé à un interpréteur est bien exécuté. C’est la différence entre écrire une recette et la donner au cuisinier. Notre premier filtre traitait les deux de la même façon et laissait passer les commandes dangereuses cachées dans une recette que quelqu’un donnait au cuisinier.
Et une surprise de plus : d’autres hooks peuvent réécrire la commande avant le tien. Nous utilisons rtk, un outil qui raccourcit la sortie des commandes pour que l’agent consomme moins de tokens. Il fonctionne avec son propre hook, qui réécrit chaque commande en lui ajoutant un préfixe : gh pr merge devient rtk gh pr merge. Et Claude Code ne garantit pas l’ordre dans lequel les hooks s’exécutent. Quand l’autre passait en premier, notre garde ne reconnaissait pas la commande et la laissait passer. La même commande a été bloquée dans un dépôt et est passée dans un autre.
La correction a consisté à ne plus supposer sous quelle forme arrive la commande. La garde reconnaît la commande seule comme avec ce préfixe devant, et chaque forme a son cas dans le test. Si demain un autre outil réécrit les commandes autrement, c’est dans le test qu’il faudra l’ajouter.
5. La liste des indésirables contre la liste des invités
Une boîte de nuit peut contrôler l’entrée de deux façons : avec une liste de personnes indésirables ou avec une liste d’invités. Avec la première, tout le monde entre sauf ceux qui ont déjà posé problème. Avec la seconde, seul entre qui est inscrit.
Notre garde de production a commencé avec une liste des indésirables : ces commandes contre les serveurs, non. Quand nous l’avons vraiment mise à l’épreuve, nous avons trouvé un chemin qui n’était pas sur la liste et qui permettait d’exécuter ce qu’on voulait en production. C’était exactement ce que la garde prétendait empêcher, par une porte que personne n’avait notée.
Nous l’avons retournée. C’est maintenant une liste d’invités : elle énumère les requêtes en lecture seule autorisées et bloque tout le reste. Un nouvel outil ou une commande que nous ne connaissions pas comptent comme dangereux jusqu’à ce que quelqu’un décide le contraire.
Le même principe vaut à l’intérieur du code. Compare ces deux règles pour une commande qui efface des données :
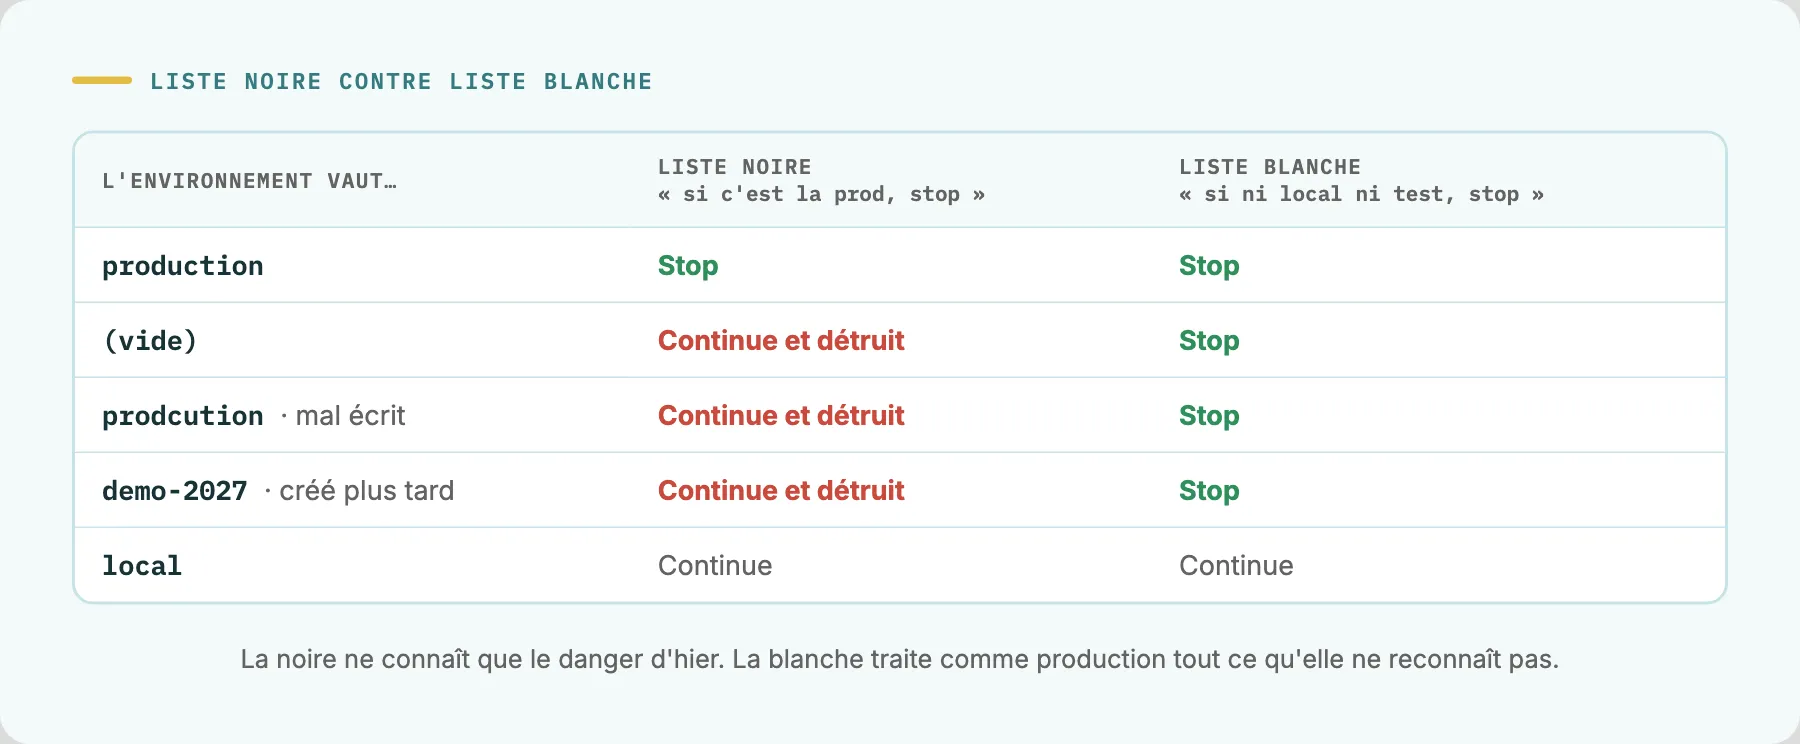
La liste des indésirables laisse passer, et détruit, quand la variable arrive vide, mal orthographiée ou avec le nom d’un nouvel environnement. Celle des invités traite comme la production tout ce qu’elle ne reconnaît pas.
6. Un panneau n’est pas un tourniquet
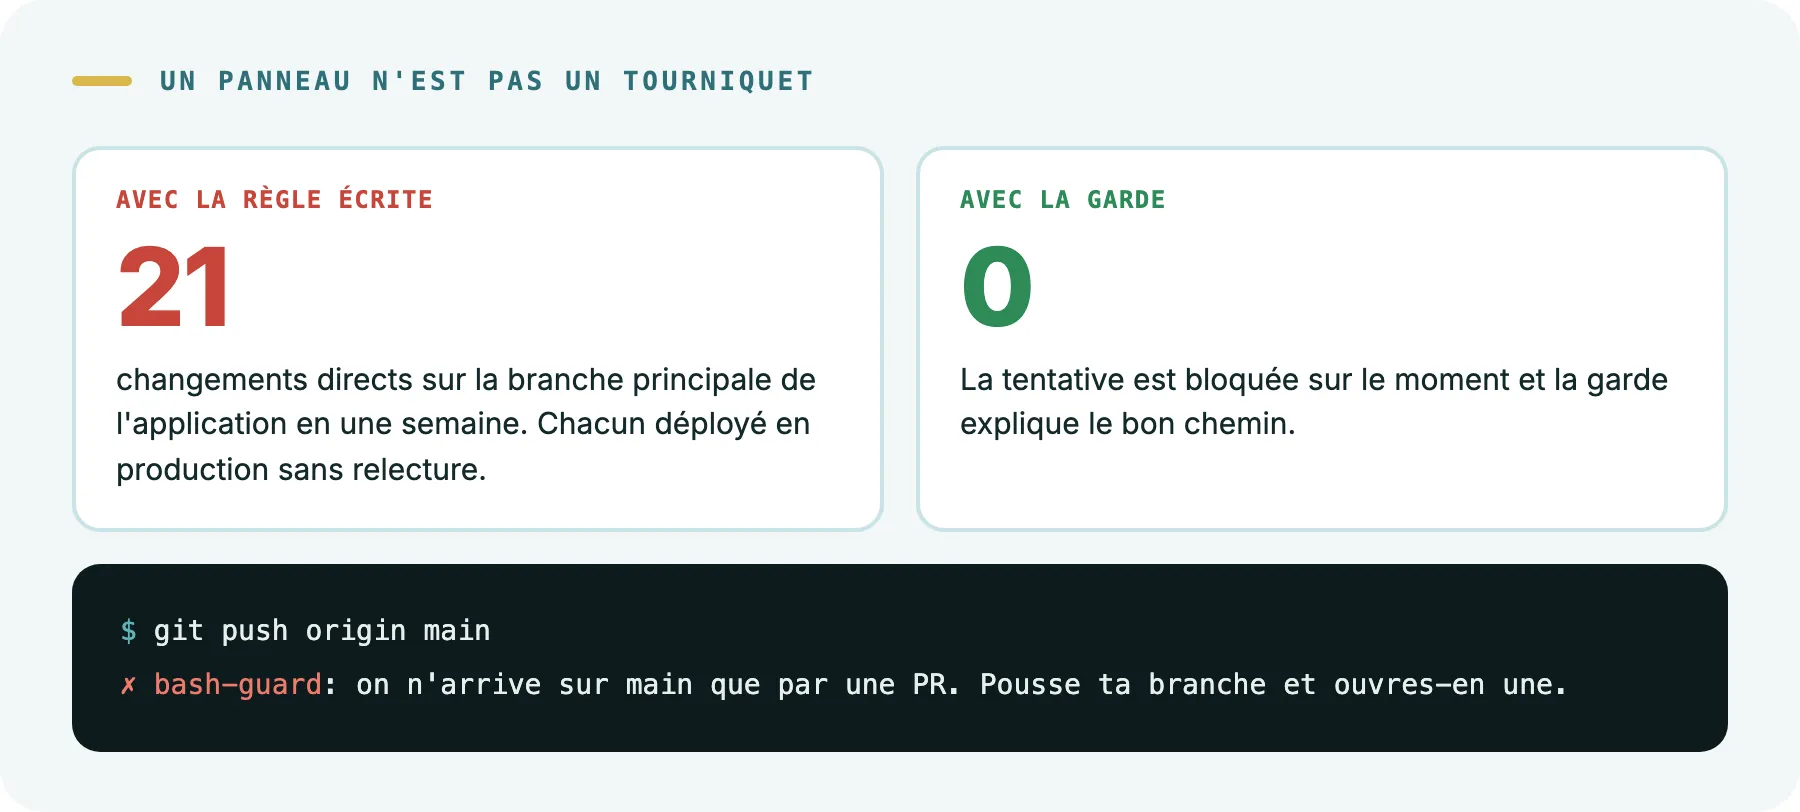
Les règles écrites sont des panneaux : « accès interdit », « pelouse interdite ». Une garde est un tourniquet de métro : sans ticket, tu ne passes pas, que tu l’aies lu ou non.
Nous avions la règle écrite : les changements vers la branche principale entrent toujours par une PR relue, jamais directement. Et l’agent la connaissait, parce qu’elle figure dans le protocole qu’il lit au début de chaque session. Quand nous avons enfin mesuré, nous avons trouvé 21 changements directs sur la branche principale de l’application en une semaine. Chacun a été déployé en production sans relecture. Personne n’a contourné la règle exprès. Simplement, il n’y avait aucun tourniquet pour la faire respecter.
L’autre alerte nous est venue de la production. Une session a écrit 20 lignes dans la base de données de production au moyen d’une commande à distance, et rien, entre l’identifiant et la base de données, n’a posé la moindre question. Depuis, contre la production, on ne fait que lire, et la clé n’est pas à la portée de l’agent : c’est une personne qui l’a.
Pourquoi des hooks et pas les règles de permissions fournies avec Claude Code ? Parce que nous voulions que la protection ne dépende pas de la façon dont chaque session est configurée. Nous travaillons avec des sessions longues et assez autonomes, et un hook s’exécute toujours.
7. Deux personnes modifient le même document et l’une enregistre une vieille copie par-dessus
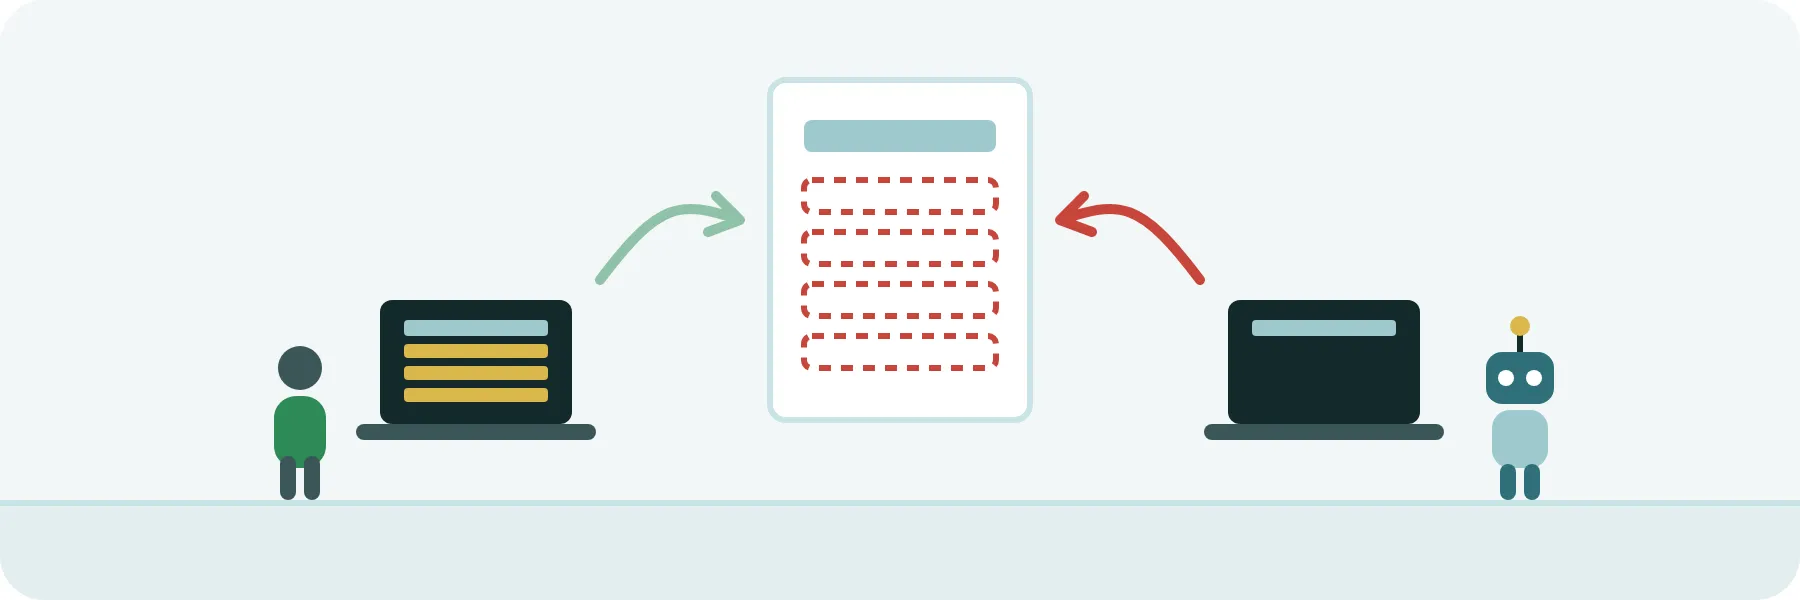
Celle-ci, quiconque a travaillé sur des documents partagés la connaît. Tu ouvres le document le matin et tu travailles sur ta partie. Pendant ce temps, une collègue ajoute sa section et enregistre. L’après-midi, tu enregistres à ton tour, depuis ta copie du matin, et sa section disparaît. Personne n’a rien effacé exprès.
Ça nous est arrivé avec du code, et en production. Plusieurs sessions travaillent en même temps sur le même dépôt. L’une a préparé son changement à partir d’une photo de la branche principale qu’une autre session venait de faire bouger. Le résultat ressemblait à un changement normal, il a passé tous les tests et la relecture, et en entrant il a annulé quatre changements précédents qui étaient déjà en production.
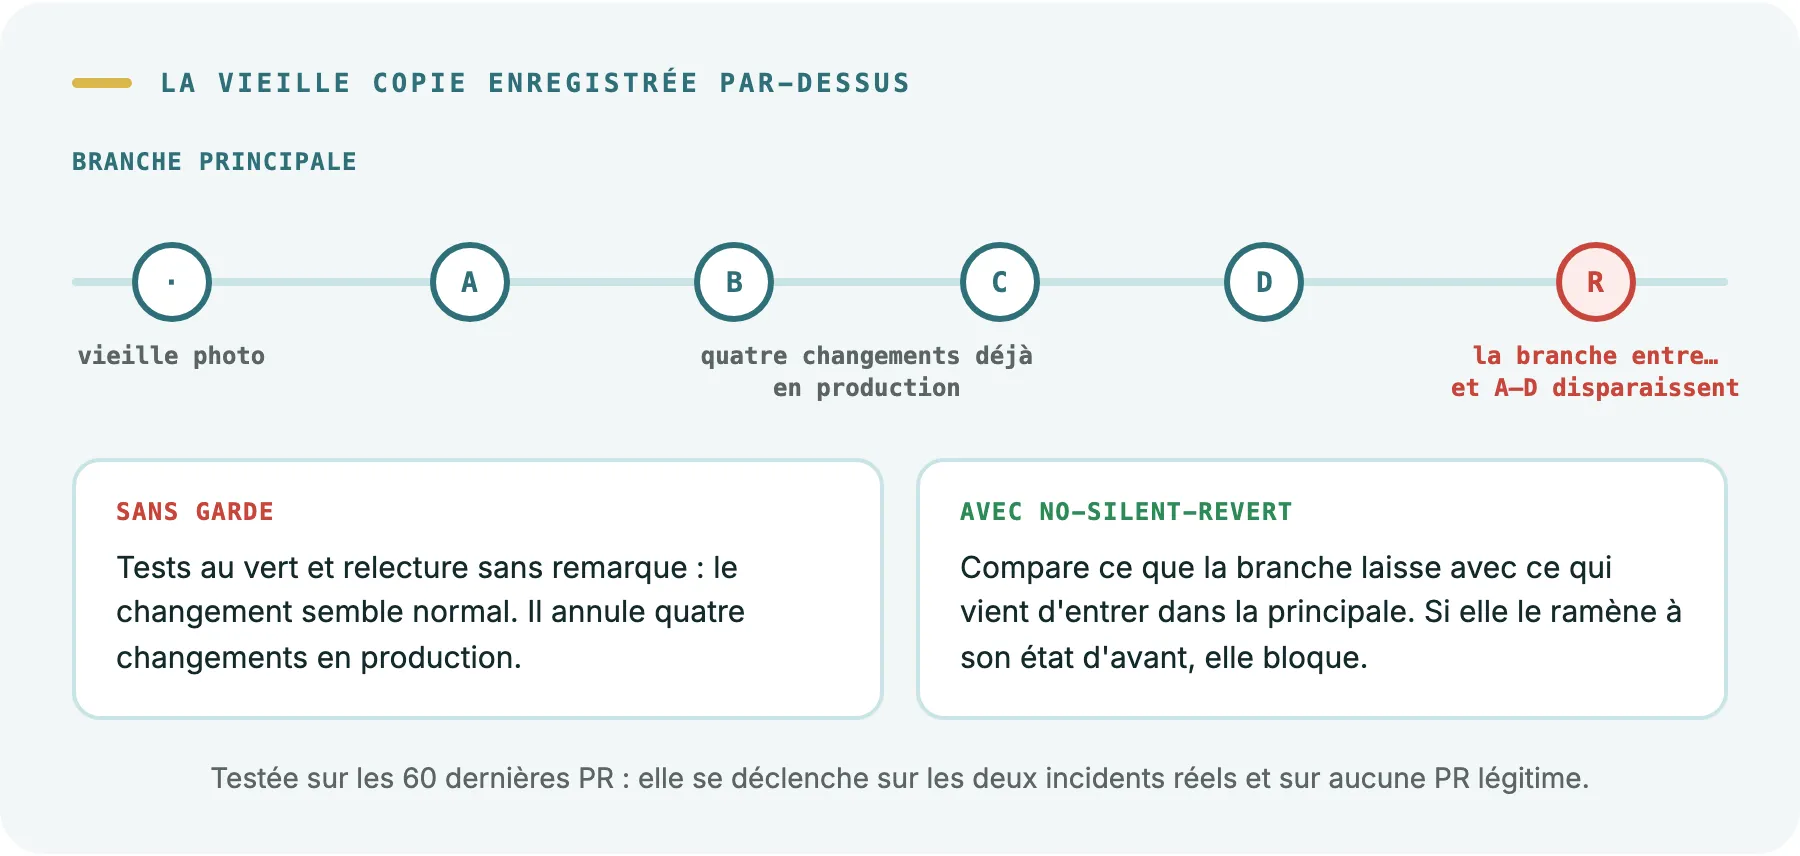
La garde qui en est sortie vérifie, avant chaque push et chaque merge, si le changement ramène à leur état précédent des fichiers qui viennent de changer sur la branche principale. Avant de l’activer, nous l’avons testée sur les 60 dernières PR de nos deux dépôts principaux : elle se déclenche sur les deux incidents réels et sur aucune PR légitime. Si tu veux vraiment annuler quelque chose, tu le dis dans le message du changement et ça passe.
Personne n’aurait écrit cette garde à l’avance. Elle naît du fait de traiter chaque incident comme une question : est-ce qu’une machine pourrait détecter ça ? Si la réponse est oui, cela devient une garde, avec ses tests.
Ce que nous avons retiré
Tout cela s’additionne, et il est arrivé un moment où ça s’additionnait trop. « Tout ce que nous faisons est très lent » : plus d’une heure d’attente pour certaines vérifications, et des déploiements de test que le changement suivant rendait obsolètes.
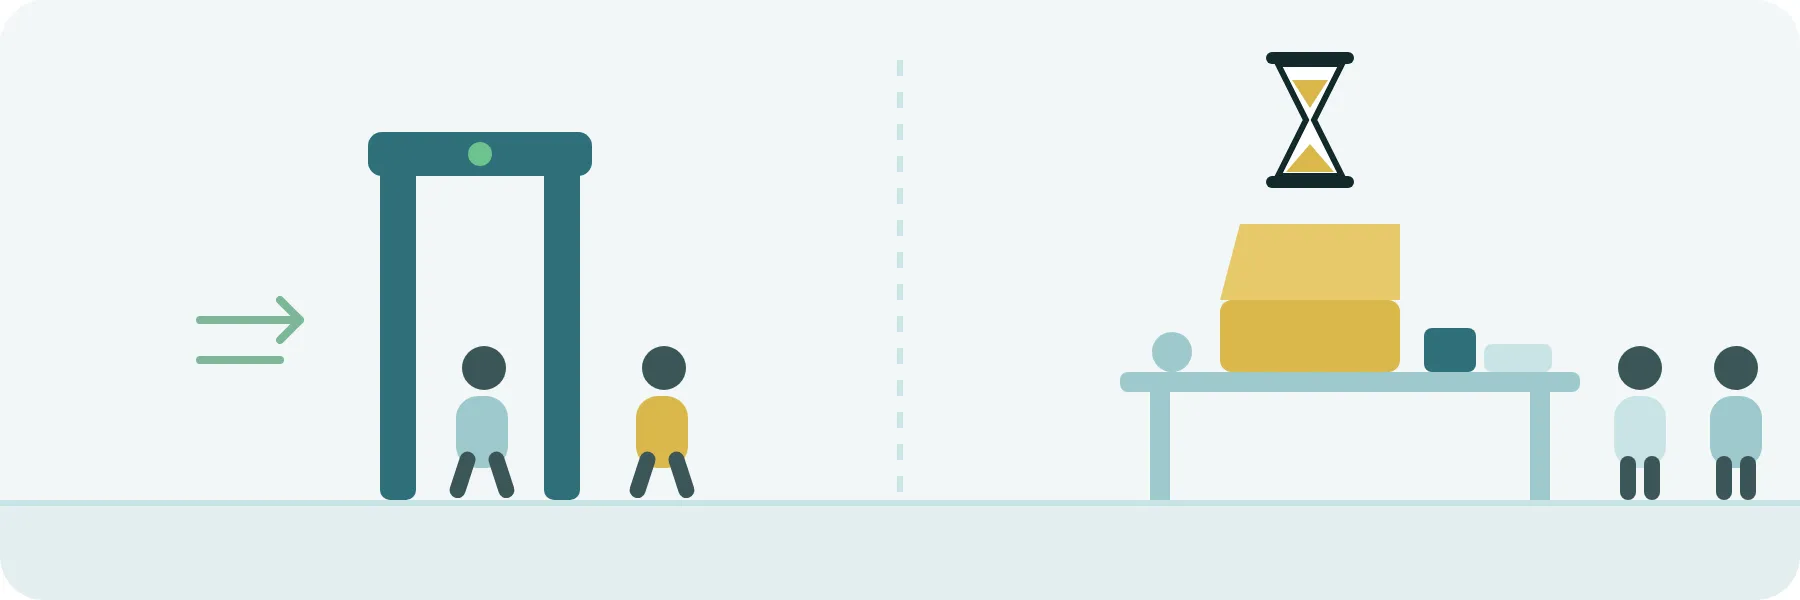
En mesurant, nous avons vu que sous le mot « gardes » se cachaient deux choses très différentes. Pour revenir à l’aéroport :
- Le portique de sécurité, ce sont les gardes qui bloquent les commandes dangereuses. Elles coûtent quelques millisecondes par commande et évitent les catastrophes.
- La fouille complète de chaque valise, ce sont les vérifications lentes : certains tests exhaustifs ou le déploiement d’un environnement de test à chaque changement. C’est là que partaient les heures, et personne n’avait revérifié si chacune en valait encore la peine.
Deux n’en valaient plus la peine, et nous les avons retirées du chemin de chaque changement :
-
Les tests de mutation en local. Un test de mutation introduit exprès de petites erreurs dans le code (il change un
>en>=, supprime une ligne) et vérifie si les tests s’en aperçoivent. S’ils ne s’en aperçoivent pas, ces tests ne protègent pas autant qu’il y paraît. C’est très utile, mais dans l’application nous mutions les fichiers entiers touchés par chaque changement, ce qui prenait entre six et dix minutes, et parfois des heures. Désormais, chaque tâche ne mute que ce que son changement ajoute : elle retire chaque nouvelle condition, une par une, et regarde si un test s’en aperçoit. Cela prend quelques secondes et vise exactement ce qui compte, parce qu’avec des milliers de tests, la question utile n’est pas de savoir s’il y a des tests, mais si ce changement en apporte un qui le surveille.Nous avons aussi coupé la mesure hebdomadaire de tout le code. Elle coûtait des milliers de minutes de CI par mois et allait rarement jusqu’au bout : sur les huit dernières, une seule a terminé. Elle donnait une note globale sur laquelle personne n’agissait.
-
Le déploiement sur staging à chaque push d’une PR inachevée. Staging est une copie de l’application où l’on regarde le changement avant la production. Avant, chaque fois que l’agent poussait un changement sur sa PR, tout staging était redéployé : environ 8 minutes. Une PR recevait en moyenne presque trois push, et chaque déploiement rendait le précédent obsolète avant que quiconque ne l’ait regardé. Dans l’application, cela faisait environ 16 minutes par PR à construire quelque chose que personne ne regardait. Désormais, la PR naît en brouillon et ne déploie que lorsqu’elle est prête.
Le portique est resté. Une garde qui coûte quelques millisecondes et arrête une catastrophe par mois est ce qu’il y a de moins cher dans tout le système.
Un hook, c’est du code de production
S’il fallait le résumer en une idée : un hook qui sert de garde est du code de production et mérite le même traitement.
- Il a des tests. Les nôtres comptent 336 cas, chacun avec une vraie commande et ce que la garde devrait en faire. Ils commencent par les commandes inoffensives qui ne devraient pas être bloquées.
- Il se met lui-même à l’épreuve. Pour chaque garde, nous avons une version cassée exprès, et les tests doivent la détecter. C’est comme faire un exercice avec une valise piégée : si le portique ne sonne pas, le portique ne fonctionne pas.
- Dans le doute, il ferme. S’il ne peut pas vérifier, il bloque.
- Il se teste là où il sert. Que le script fonctionne ne suffit pas. L’agent doit recevoir l’avertissement.
- Il mérite sa place. Nous n’automatisons que ce qui échoue sans prévenir et qu’une machine peut détecter. Le reste s’écrit, avec son pourquoi.
Les agents ne se fatiguent pas, mais ils ne se méfient pas non plus. Cette méfiance, c’est nous qui l’apportons, sous forme de gardes qui s’appliquent toutes seules. Nous sommes très méfiants, mais seulement envers les agents : c’est pour ça que chaque règle qui compte est un tourniquet, pas un panneau.
Et nous continuerons à être très méfiants.
